我是豆豆

吃饭,睡觉,打豆豆

《概率导论》终于是读完了,如果说前面几个章节还算是我能够自己学习并且理解的话,到了后面已经完全的变为了纯数学概念的转换。无论是贝叶斯还是切比雪夫链,我光是看都看不懂,于是,我的建议是后面的几个张章节的衍生,还是自己另外找视频辅助。书本确实比较符合我们的思维速度,所以一开始建立基础知识的时候,看书可以帮助我们更好的理解,但是到了后面,尤其是数学,很多时候简单的一个符号就需要大量的计算和理解,所以我们需要视频辅助,根据视频讲解的内容让我们更好的理解这些概念。

这就像是我最近在辅导孩子的数学作业一样的感受,如果说我在孩子这个年纪,那些数学的方法和思维让我想,凭空想出来,说实话我想不出来,而且就算是想出来了,没有经常使用,随着时间或者当时的状态,我估计我也搞不清楚这些概念和规律的。但是那天教学孩子的时候,我在自己做了两道题之后就发现了其中的奥妙,然后花费2个下午的时间将这个奥妙分解成孩子能够理解的语言,简单而言就是通过将分数乘法转变为分数减法来计算有规律的分数的n项之和。这种题目一般不会是数学卷子的最后大题,但是会是倒数第二道那种地位,属于不是强制要求,但是考验你思维灵活度的题目。如果你理解了,看懂了,那么这种题目做起来就得心应手,不会,也不会对你的基础知识有太多的影响。

现在想来,数学就是这么一样东西。数学是一个不定的学科,他的高阶题目是没有一个定论的。是,有时候是有比如取对数将乘法变为加减这种小技巧,但是正如之前所说,这些小技巧一般对应的是特殊的题目,不具备广泛性,所以,很多时候你光记住技巧是没有用处的,更加需要的是你的思维。而数学的一个基本思维就是:将不知道的问题变为已知的问题。就好像笑话说的:一个数学家看到房子着火的话会找来消防队,如果这个房子倒塌了,那么数学家就会把房子点着火,然后再来找到消防队。这就是一个基本的数学思维,万剑归宗般的一套解决理论。那么我们是记不住那一万把剑的,所以我们只需要记住那个思维就行,而如何记住这些思维:我觉得就是刷题。遇见的事务多了,你就自然而然的了解其中的真谛。

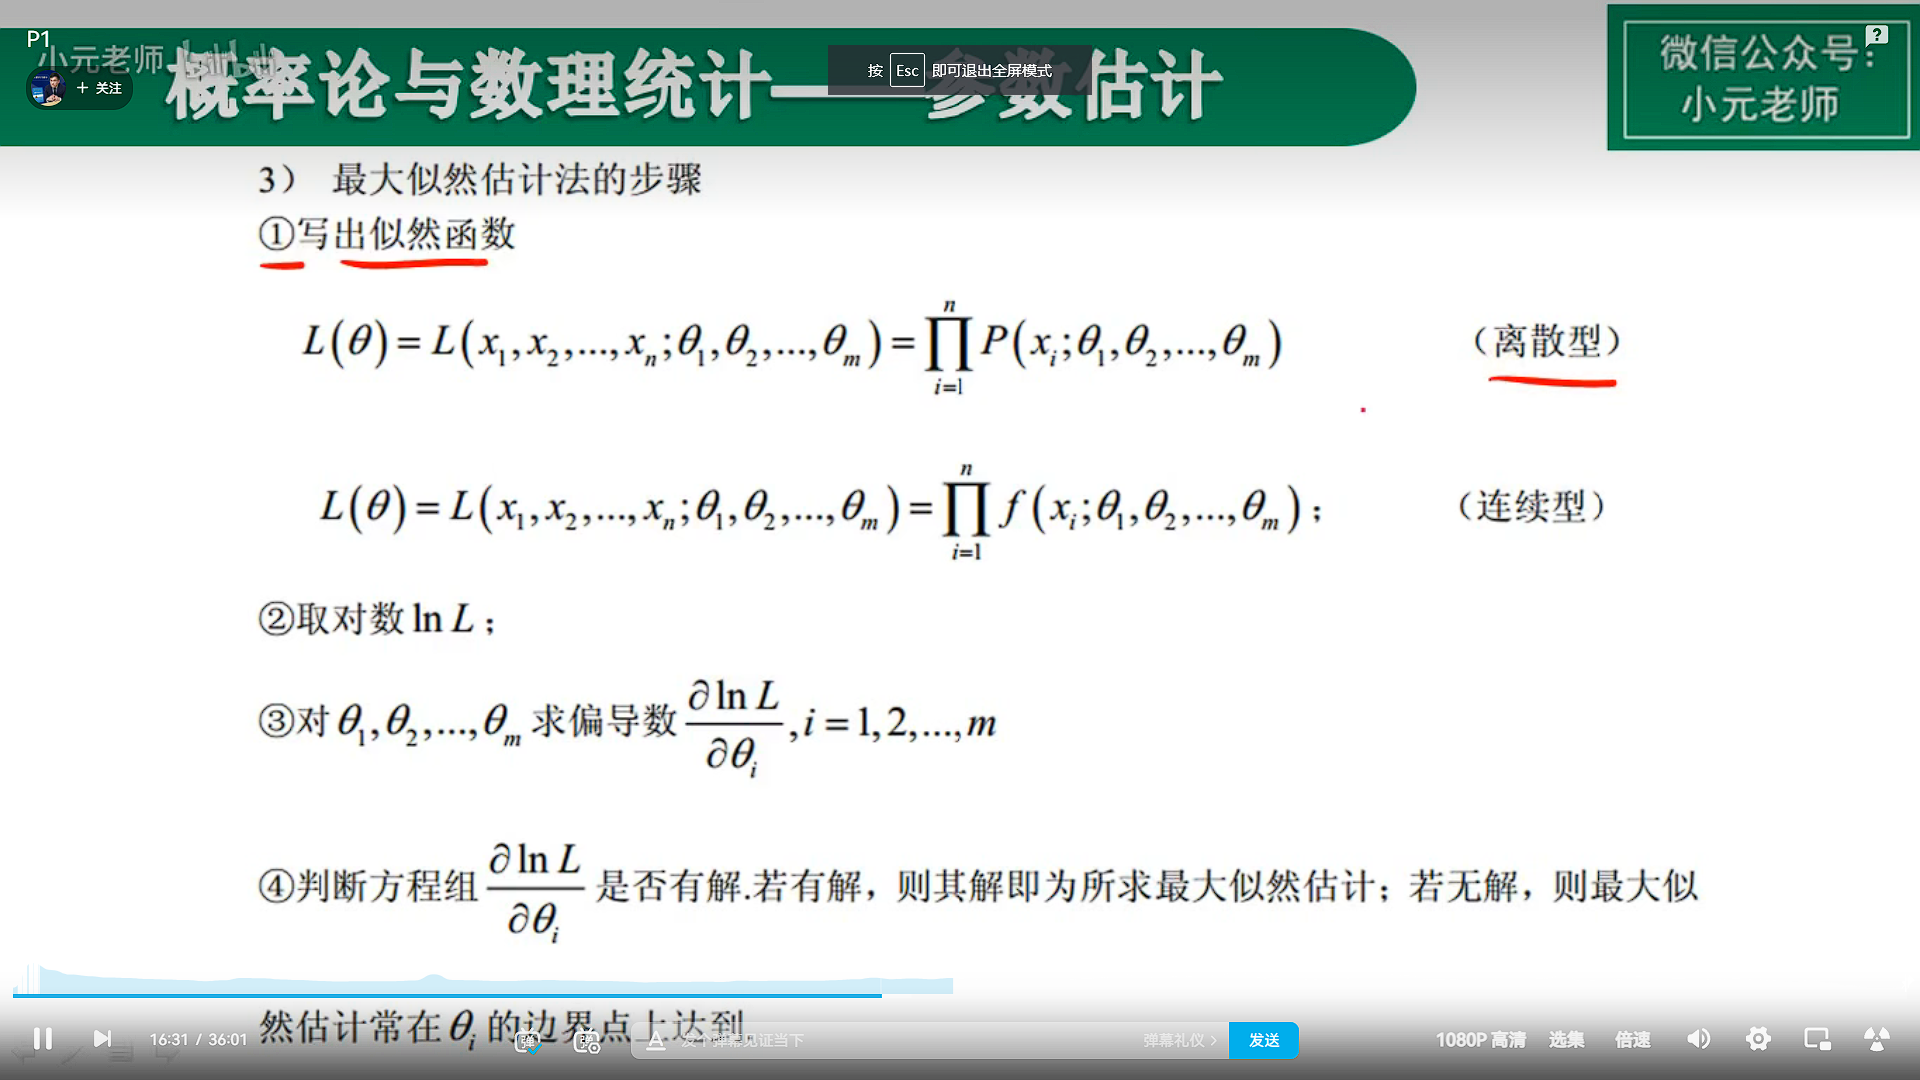
这大概就是我大学高数挂科的原因了吧,高中的我数学算不上好,但也属于能答对最后一道大题的几个人之一吧,但是到了大学,高数最后还是靠老师的施舍才能过。我尤为记着拿到大学考试的时候拿到的高数卷子:这是什么,怎么和课本上的完全不一样啊。我还停留在课本上,但是老师出的已经超出了课本。在看《概率导论》的最后几章节时候,我是看的晕乎转向的,什么是最大似然,为啥取最大?实际意义,或者数学意义在哪?然后不得已,B站找了个视频观看,原来是对应求最大可能性的概率,原来是概率分布下的概率乘数最大化,来计算概率。简单明了,再去翻看书里,隐晦,难懂,上来就是假设,然后公式,没有一点铺垫。所以单单看书本是无法完全理解这些方法的内容的,其实很简单:通过样本数据反推数据发生的概率,通过对数求导,再求和,计算出最大值。反馈到实际意义就是这件事发生的概率。

20220730154010

这算是一个总结吧,要完全理解一个数学概念还是需要刷题,需要看视频,读几本一样的数,不如多刷几道题目,教材一本就够,其他的靠自己刷题理解。

数据概率导论

基础知识

  • 集合

    1. 集合运算:并,交,补

    2. 集合代数:德摩尔定律即补集的并集等于原集的交集反之亦然

  • 概率模型

    1. 样本空间:空间内结果相斥

    2. 概率率:1.非负性,2.可加性,3.归一化

      • 概率律性质

        • 若$A\subset B,则P(A) \leq P(B) $

        • P(A∪B)=P(A)+P(B)−P(A∩B)P(A \cup B )=P(A)+P(B)-P(A\cap B)

        • P(A∪B)≤P(A)+P(B)P(A\cup B)\leq P(A)+P(B)

        • P(A∪B∪C)=P(A)+P(Ac∩B)+P(Ac∩Bc∩C)P(A \cup B \cup C)=P(A)+P(A^c \cap B)+P(A^c\cap B^c \cap C)

    3. 序贯模型:针对有序事件

    4. 离散模型:样本空间内由有限个可能的结果组成:P(s1,s2,⋯ ,sn)=P(s1)+P(s2)+⋯+P(sn)P({s_1,s_2,\dotsb,s_n})=P(s_1)+P(s_2)+\dotsb+P(s_n)

    5. 连续模型:试验的样本空间为连续集合

    6. 贝特斯悖论:对于同一事件不同的模型导致结论不确定。例:三门问题。

    7. 条件概率:P(A∣B)=事件A∩B的试验结果数事件B发生的试验结果数=P(A∩B)P(B)P(A|B)=\frac{事件A\cap B的试验结果数}{事件B发生的试验结果数}=\frac{P(A\cap B)}{P(B)}是一个概率律.

      • 乘法规则:P(∩i=1nAi)=P(A1)P(A2∣A1)P(A3∣A1∩A2)⋯P(An∣∩i=1n−1Ai)P( \cap _{i=1}^nA_i)=P(A_1)P(A_2|A_1)P(A_3|A_1\cap A_2)\dotsb P(A_n|\cap_{i=1}^{n-1}A_i)
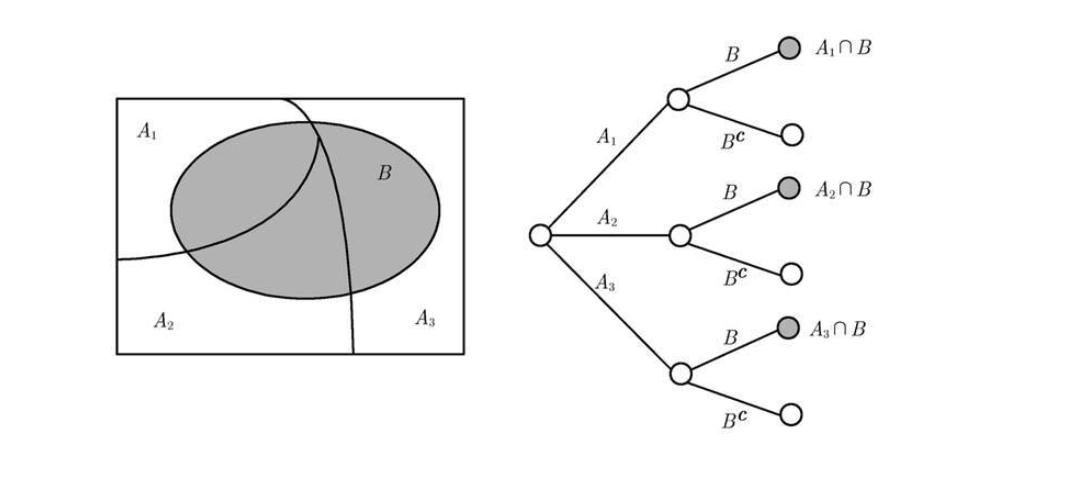
    8. 全概率定理:P(B)=∑i=1nP(An∩B)P(B)= \sum_{i=1}^n P(A_n \cap B)20220606101748

      • 与条件概率的差异

        • 全概率是通过样本空间事件AiA_i和目标事件B相交概率反算出B事件的概率

        • 条件概率为事件A在事件A和B共同发生的前提下的概率

      • 贝叶斯准则:设A1,A2,⋯ ,AnA_1,A_2,\dotsb,A_n为互补相容的事件,且形成样本空间的所有分割

        • 不是很重要的推导过程P(Ai∣B)=P(Ai∩B)P(B)=P(Ai)P(B∣Ai)P(A1)P(B∣A1)+⋯+P(An)P(B∣An)P(A_i|B)=\frac{P(A_i\cap B)}{P(B)}=\frac{P(A_i){P(B|A_i)} }{P(A_1)P(B|A_1)+\dotsb +P(A_n)P(B|A_n) }

        • 将P(A∣B)P(A|B)和P(B∣A)P(B|A)联系到一起,且可以进行因果推理。

    9. 独立性:P(A∣B)=P(A)  ⟺  P(A∩B)=P(A)P(B)P(A|B)=P(A)\iff P(A\cap B)=P(A)P(B)其中P(B)>0P(B)>0

      • 条件独立:P(A∩B∣C)=P(A∣C)P(B∣C)  ⟺  P(A∣B∩C)=P(A∣C)P(A\cap B|C)=P(A|C)P(B|C)\iff P(A|B\cap C)=P(A|C)
    10. 一组事件独立:任意两两事件且所有事件相互独立

      • 独立试验序列:重复的相互独立的试验

      • 如果结果只有两种可能称为:伯努利试验序列:p(k)=(nk)pk(1−p)n−kp(k)={n\choose{k} }p^k(1-p)^{n-k}

        • 其中(nk){n\choose{k} }为二项式系数n!k!(n−k)!\frac{n!}{k!(n-k)!},为nn选kk的组合数
      • 计数法

        • r阶段的结果:n1n2⋯nrn_1n_2\dotsb n_r

        • n选k排列:n!(n−k)!\frac{n!}{(n-k)!}

        • n选k组合:二项式系数(nk)=n!k!(n−k)!{n\choose{k} }=\frac{n!}{k!(n-k)!}

        • 分割:(nn1)(n−n1n2)⋯(n−n1−⋯−nr−1nr){n \choose{n_1} }{n-n_1 \choose{n_2} }\dotsb { {n-n_1-\dotsb -n_{r-1} } \choose{n_r} }


离散模型:值域为有限个集合

  • 分布列:用pXp_X表示随机变量XX的分布:pX(x)=P({X=x})p_X(x)=P(\{X=x\})

    • 伯努利随机变量:pX(k)={p,若k=1,1−p,若k=0.p_X(k)=\begin{cases} p,若k=1, \\ 1-p,若k=0. \end{cases}

    • 二项随机变量:

      pX(k)=P(X=k)=(nk)pk(1−p)n−k,k=0,1,⋯ ,np_X(k)=P(X=k)={n \choose{k} }p^k(1-p)^{n-k}, k=0,1,\dotsb,n

    • 几何随机变量:pX(k)=(1−p)k−1p,k=1,2,3,⋯p_X(k)=(1-p)^{k-1}p,k=1,2,3,\dotsb

    • 泊松随机变量:

      pX(k)=e−λλkk!,k=0,1,2,3⋯ ,p_X(k)=e^{-\lambda}\frac{\lambda^k}{k!},k=0,1,2,3\dotsb,

    • 随机变量的函数:

      pY(y)=∑{x∣g(x)=y}pX(x)p_Y(y)=\sum_{ \{x|g(x)=y\} }p_X(x)

  • 离散分布列之间关系

    • 伯努利随机是n=1n=1二项随机变量,二项随机变量是为在nn次的kk次成功,而几何随机这是一种累计直至第kk次成功,泊松随机变量更具有现实意义,在n很大,p很小即大规模发生事件下的小概率发生事件应用
  • 多个随机变量的联合分布列:

    • 联合分布并没有严格区分离散模型和连续模型,只是因为模型不一样导致计算过程不一样。

    • pX,Y=P(X=x,Y=y)p_{X,Y}=P(X=x,Y=y),其中pX,Yp_{X,Y}称之为联合分布,将pX(x)=∑ypX,Y(x,y),  pY(y)=∑xpX,Y(x,y).p_X(x)=\sum_y{p}_{X,Y}(x,y),\quad\;p_Y(y)=\sum_x{p}_{X,Y}(x,y).为边缘分布。

  • 条件:正如第一章,所有概率都会有条件和独立的问题存在。这是全概率准则的基础。

    • 单一事件的随机变量:pX∣A(x)=P(X=x∣A)=P({X=x}∩A)P(A)p_{X|A}(x)={\rm P}(X=x|A)=\frac{ {\rm P}(\{X=x\}\cap{A})}{ {\rm P}(A)}

    • 给定另一个随机变量值的条件下的随机变量:$$

    • 给定另一个随机变量值的条件下的随机变量:pX∣Y(x∣y)=P(X=x∣Y=y)p_{X|Y}(x|y)={\rm P}(X=x|Y=y)公式pX,Y(x,y)=pY(y)pX∣Y(x∣y)p_{X,Y}(x,y)=p_Y(y)p_{X|Y}(x|y),或利用pX,Y(x,y)=pX(x)pY∣X(y∣x)p_{X,Y}(x,y)=p_X(x)p_{Y|X}(y|x)

  • 独立性

    • 定义:P(X=x且A)=P(X=x)P(A)=pX(x)P(A)对一切x成立{\rm P}(X=x 且 A)={\rm P}(X=x){\rm P}(A)=p_X(x){\rm P}(A) 对一切 x 成立,如果P(A)>0P(A)>0,则P(X=x且A)=pX∣A(x)=pX(x)对一切x成立.{\rm P}(X=x 且 A)=p_{X|A}(x)=p_X(x) 对一切 x 成立.
  • 条件独立:

    • 随机变量之间的相互独立性与随机变量和随机事件的相互独立性的概念是完全相同的.

一般随机变量:连续随机变量

  • 连续随机变量和概率密度函数(PDF):

P(X∈B)=∫bf(x)dxP(X\in B)=\displaystyle\int_b{f(x)}{dx}我们称f(x)f(x)为X的概率密度函数,

  • 端点无用:P(X=a)=∫aaf(x)dx=0P(X=a)=\displaystyle\int_a^a{f(x)}{dx}=0,所以区间端点的概率计算无用:P(a≤X≤b)=P(a<X≤b)=P(a≤X<b)=P(a<X<b)P(a\leq X\leq b)=P(a < X\leq b)=P(a\leq X < b)=P(a < X < b)

  • 关于PDF性质的小结:

    1. 设 XX 的PDF(概率密度函数)为 fX(x)f_X(x) .fX(x)≥0f_X(x)\geq 0对一切 x 成立.且可以大于1

    2. ∫−∞∞fX(x)dx=1\int^\infty_{-\infty}f_X(x)\text{d}x=1

    3. 设 δ 是一个充分小的正数, 则 P([x,x+δ])≈fX(x)⋅δ\text{P}([x,x+\delta])\approx f_X(x)\cdot\delta.其中P([x,x+δ])\text{P}([x,x+\delta])满足概率律,所以fX(x)f_X(x)是可以大于1的

    4. 对任何实数轴上的子集BB,P(X∈B)=∫BfX(x)dx{\rm P}(X\in{B})=\displaystyle\int_{B}{f}_X(x)dx.

  • 常见分布列

    1. 均匀随机变量:即f(X)f(X)在[a,b][a,b]上均匀分布

    2. 指数随机变量:$f_X(x)=\begin{cases}

    \lambda e^{-\lambda x},若x\geq 0 \

    0 ,其他\end{cases}$

    1. 正态随机变量:fX(x)=12πσe−(x−μ)2/(2σ2),f_X(x)=\frac1{\sqrt{2\pi}\sigma}{\rm e}^{-(x-\mu)^2/(2\sigma^2)},

      • 线性变换之下,随机变量的正态性保持不变,体现在方差和期望

      • 正态随机变量 Y 的期望μ\mu为0, 方差σ2\sigma^2为1,则 Y 称为标准正态随机变量

      • 结合上述性质,可以将非标准快速转换为标准,再利用标准正态速查表进行快速计算正态分布的结果


期望,均值,方差

  1. 期望:

    • 期望:我们把px×xpx\times x称之为期望值M=E[X]M=E[X]

    • 离散期望值为M=m1k1+m2k2+⋯+mnknkM=\frac {m_1k_1+m_2k_2+\dots+m_nk_n}{k},这是期望值得原本定义,在这边假定了kk值很大,将kik≈pi\frac {k_i}{k} \approx p_i,最后得出E[X]=∑xxpX(x)E[X]=\sum_x xp_X(x)

    • 连续随机期望依据定义:E[X]=∫−∞∞xfX(x)dx.{\rm E}[X]=\int_{-\infty}^{\infty}xf_X(x){d}x.

    • 通常我们会将其看作分布列的重心

    • 期望规则

      • 随机变量Y=aX+bY=aX+b,则E[Y]=aE[X]+b,var[Y]=a2var(X)E[Y]=aE[X]+b,var[Y]=a^2var(X)

      • var(X)=E[X2]−(E[X])2var(X)=E[X^2]-(E[X])^2

    • 条件期望:根据定义E[X∣A]=∑xxpX∣A(x){\rm E}[X|A]=\sum_xxp_{X|A}(x)

  2. 方差

    • 方差:记作var[X]var[X],var[X]=E[(X−E[X])2]var[X]=E[(X-E[X])^2]

    • 标准差:σX=var(X).\sigma_X=\sqrt{\text{var}(X)}.

    • 连续随机方差:var(X)=E[(X−E[X])2]=∫−∞+∞(x−E[X])2fX(x)dx\text{var}(X)=E[(X-E[X])^2]=\int_{-\infty}^{+\infty}(x-E[X])^2f_X(x)dx

    • 两者都是衡量XX在期望周围的分散程度,方差衡量标准为平方米,而标准差为米。

  3. 常用的随机变量的均值和方差

    • 伯努利随机变量:E[X]=1⋅p+0⋅(1−p)=p\\E[X]=1\cdot{p}+0\cdot(1-p)=p\\,E[X2]=12⋅p+02⋅(1−p)=p{\rm E}[X^2]=1^2\cdot{p}+0^2\cdot(1-p)=p\\,var(X)=E[X2]−(E[X])2=p−p2=p(1−p)\text{var}(X)={\rm E}[X^2]-({\rm E}[X])^2=p-p^2=p(1-p)

    • 离散均匀随机变量E[X]=a+b2,var[X]=(b−a)(b−a+2)12\\E[X]=\frac{a+b}{2},\\var[X]=\frac{(b-a)(b-a+2)}{12}

    • 二项分布式:E[X]=np\\E[X]=np,var(X)=∑i=1nvar(Xi)=np(1−p)\\\text{var}(X)=\sum_{i=1}^n\text{var}(X_i)=np(1-p)

    • 泊松随机变量:E[X]=λE[X]=\lambda,var(X)=E[Y2]−(E[Y])2=λ(λ+1)−λ2=λvar(X)=E[Y^2]-(E[Y])^2=\lambda(\lambda+1)-\lambda^2=\lambda

    • 几何变量:E[X]=1p{\rm E}[X]=\frac 1 p

    var(X)=E[X2]−(E[X])2=2p2−1p−1p2=1−pp2.\\\text{var}(X)={\rm E}[X^2]-({\rm E}[X])^2=\frac2{p^2}-\frac1p-\frac1{p^2}=\frac{1-p}{p^2}.


    • 均匀随机变量:

      E[X]=a+b2E[X]=\frac{a+b}{2}\\,var(X)=E[X2]−(E[X])2=a2+ab+b23−(a+b)24=(b−a)212.\text{var}(X)={\rm E}[X^2]-({\rm E}[X])^2=\frac{a^2+ab+b^2}3-\frac{(a+b)^2}4=\frac{(b-a)^2}{12}.

    • 指数随机变量:E[X]=1λvar(X)=1λ2{\rm E}[X]=\frac1\lambda\quad\text{var}(X)=\frac1{\lambda^2}

    • 正态分布:E[X]=μ,var(X)=σ2.{\rm E}[X]=\mu,\quad\text{var}(X)=\sigma^2.

极限理论

  1. 大数定律:所以当 n→∞n\to\infty时,MnM_n 的方差趋于0.也就是说,MnM_n 的分布大部分就必然与均值 μ\mu特别接近.这种现象就是大数定律的内容,即随机变量序列 MnM_n,从大样本意义上看,收敛于 $X_i $的均值 μ\mu .按通常的解释,当样本量很大的时候,从 X 抽取的样本平均值就是 E[X] ,大数定律就为此提供了一个数学理论基础.

  2. 中心极限定理:用 SnS_n 减去 nμn\mu ,可以得到零均值随机变量序列 S_n-n\mu ,然后再除以σn\sigma\sqrt{n},就得到随机变量序列Zn=Sn−nμσn.Z_n=\frac{S_n-n\mu}{\sigma\sqrt{n} }.易证明E[Zn]=0,   var(Zn)=1.{\rm E}[Z_n]=0, \ \ \ \text{var}(Z_n)=1.因为ZnZ_n的均值和方差不依赖于样本容量 n ,所以它的分布既不发散,也不收敛于一点.中心极限定理 就研究ZnZ_n的分布的渐近性质,并且得出结论:当nn充分大的时候,ZnZ_n的分布就接近标准正态分布.

  3. 马尔可夫不等式:P(X≥a)≤E[X]a{\rm P}(X\geq a)\leq \frac{ {\rm E}[X]}{a}

  4. 切比雪夫不等式:随机变量 X 的均值为 μ\mu,方差为σ2\sigma^2,则对任意 cc%3e0 ,P(∣X−μ∣≥c)≤σ2c2{\rm P}(|X-\mu|\geq c)\leq \frac{\sigma^2}{c^2}

  5. 通过上述四个理论,大数定理和中心极限提供了数学理论基础,而马尔可夫不等式和切比雪夫不等式则计算出来一定的概率上限。


古典模型:P(A)=含事件A的结果数nP(A)=\frac{含事件A的结果数}{n}

概率律的所有性质都在后续有应用,基于不同的模型。

条件概率也满足概率律的所有性质:P(A∣C∪B∣C)≤P(A∣C)+P(B∣C)P(A|C\cup B|C)\leq P(A|C)+P(B|C)

试着使用现实意义进行描述贝叶斯准则:通过事目标件B在特定条件下的发生概率,来反推出事件B在无条件或者特定样本空间下的概率。即在通过结果来反推出发生原因的概率。

继续不是很重要的推导过程,中间用到条件概率的乘法法则:P(A∩B∣C)=P(A∩B∩C)P(C)=P(C)P(B∣C)P(A∣B∩C)P(C)=P(B∣C)P(A∣B∩C)  ⟺  P(B∣C)P(A∣B∩C)=P(A∣C)P(B∣C)  ⟺  P(A∣B∩C)=P(A∣C)P(A\cap B|C)=\frac{P(A\cap B \cap C)}{P(C)}=\frac{P(C)P(B|C)P(A|B\cap C)}{P(C)}=P(B|C)P(A|B \cap C) \iff P(B|C)P(A|B \cap C)=P(A|C)P(B|C) \iff P(A|B\cap C)=P(A|C)

组合数即意味着含有次序

试图证明泊松变量和二项随机变量的逼近:设n→∞,p→0n\to \infty,p\to 0, 且np=λnp= \lambda将二项随机变量:$$\begin{align*}\frac{n!}{k!(n-k)!}pk(1-p){n-k}\end{align*}中中n=\frac{\lambda}{p}得到只剩下得到只剩下\lambda的式子,求极限。总结下对应意义就是在试验次数的式子,求极限。总结下对应意义就是在试验次数n很大的情况下,很大的情况下,p很小,则无限接近二项随机变量。现实意义就是:如果大规模事件出现小概率事件的次数很小,则无限接近二项随机变量。现实意义就是:如果大规模事件出现小概率事件的次数k$,可以参照二项式进行快速计算。

试着使用重心理论去理解,图像的增大和缩小会影响其重心,和XX与重心的距离,但是左移右移不影响两者距离,只影响重心位置。

依旧不是很重要的证明过程:直接使用定义法:

\begin{align*}\text{var}(X)&=\sum_x\left(x-{\rm E}[X]\right)^2p_X(x)\\&=\sum_x\left(x^2-2x{\rm E}[X]+({\rm E}[X])^2\right)p_X(x)\\&=\sum_xx^2p_X(x)-2{\rm E}[X]\sum_xxp_X(x)+({\rm E}[X])^2\sum_xp_X(x)\\&={\rm E}[X^2]-2({\rm E}[X])^2+({\rm E}[X])^2\\&={\rm E}[X^2]-({\rm E}[X])^2.\end{align*}

随机变量 X 和 Y 称为相互独立 的随机变量, 若它们满足pX,Y(x,y)=pX(x)pY(y)p_{X,Y}(x,y)=p_X(x)p_Y(y)对一切 x 和 y 成立.这等价于对于任意 x 和 y , 随机事件 X=xX=x和Y=yY=y相互独立. 最后,由公式 pX,Y(x,y)=pX∣Y(x∣y)pY(y)p_{X,Y}(x,y)=p_{X|Y}(x|y)p_Y(y)可知随机变量 XX 和 YY 的相互独立性的条件等价于:pX∣Y(x∣y)=pX(x)p_{X|Y}(x|y)=p_X(x) 对一切 x 和一切满足pY(y)>0p_Y(y)>0 的 y 成立.直观上, Y 和 X 的独立性意味着 Y 的取值不会提供 X 取值的信息.在给定事件 A 的条件下(P(A)必须大于0!)({\rm P}(A) 必须大于0!)也可以定义两个随机变量的条件独立性.在给定事件 A 的条件下,所有的事件的概率都换成关于条件 A 的条件概率. 例如, 我们称随机变量 X 和YY在给定正概率事件 AA的条件下是条件独立的

满足概率律

线性变换之下随机变量的正态性保持不变:设 X 是正态随机变量, 其均值为μ\mu, 方差为σ2\sigma^2 .若 a≠0a\not=0 和 bb 为两个常数, 则随机变量Y=aX+bY=aX+b仍然是正态随机变量, 其均值和方差由下式给出:E[Y]=aμ+b,var(Y)=a2σ2.{\rm E}[Y]=a\mu+b,\quad\text{var}(Y)=a^2\sigma^2.

数据概率导论

基础知识

  • 集合

    1. 集合运算:并,交,补

    2. 集合代数:德摩尔定律即补集的并集等于原集的交集反之亦然

  • 概率模型

    1. 样本空间:空间内结果相斥

    2. 概率率:1.非负性,2.可加性,3.归一化

      • 概率律性质

        • 若$A\subset B,则P(A) \leq P(B) $

        • P(A∪B)=P(A)+P(B)−P(A∩B)P(A \cup B )=P(A)+P(B)-P(A\cap B)

        • P(A∪B)≤P(A)+P(B)P(A\cup B)\leq P(A)+P(B)

        • P(A∪B∪C)=P(A)+P(Ac∩B)+P(Ac∩Bc∩C)P(A \cup B \cup C)=P(A)+P(A^c \cap B)+P(A^c\cap B^c \cap C)[1]

    3. 序贯模型:针对有序事件

    4. 离散模型:样本空间内由有限个可能的结果组成:P(s1,s2,⋯ ,sn)=P(s1)+P(s2)+⋯+P(sn)P({s_1,s_2,\dotsb,s_n})=P(s_1)+P(s_2)+\dotsb+P(s_n)[2]

    5. 连续模型:试验的样本空间为连续集合

    6. 贝特斯悖论:对于同一事件不同的模型导致结论不确定。例:三门问题。

    7. 条件概率:P(A∣B)=事件A∩B的试验结果数事件B发生的试验结果数=P(A∩B)P(B)P(A|B)=\frac{事件A\cap B的试验结果数}{事件B发生的试验结果数}=\frac{P(A\cap B)}{P(B)}是一个概率律. [3]

      • 乘法规则:P(∩i=1nAi)=P(A1)P(A2∣A1)P(A3∣A1∩A2)⋯P(An∣∩i=1n−1Ai)P( \cap _{i=1}^nA_i)=P(A_1)P(A_2|A_1)P(A_3|A_1\cap A_2)\dotsb P(A_n|\cap_{i=1}^{n-1}A_i)
    8. 全概率定理:P(B)=∑i=1nP(An∩B)P(B)= \sum_{i=1}^n P(A_n \cap B)20220606101748

      • 与条件概率的差异

        • 全概率是通过样本空间事件AiA_i和目标事件B相交概率反算出B事件的概率

        • 条件概率为事件A在事件A和B共同发生的前提下的概率

      • 贝叶斯准则:设A1,A2,⋯ ,AnA_1,A_2,\dotsb,A_n为互补相容的事件,且形成样本空间的所有分割

        • 不是很重要的推导过程P(Ai∣B)=P(Ai∩B)P(B)=P(Ai)P(B∣Ai)P(A1)P(B∣A1)+⋯+P(An)P(B∣An)P(A_i|B)=\frac{P(A_i\cap B)}{P(B)}=\frac{P(A_i){P(B|A_i)} }{P(A_1)P(B|A_1)+\dotsb +P(A_n)P(B|A_n) }

        • 将P(A∣B)P(A|B)和P(B∣A)P(B|A)联系到一起,且可以进行因果推理。[4]

    9. 独立性:P(A∣B)=P(A)  ⟺  P(A∩B)=P(A)P(B)P(A|B)=P(A)\iff P(A\cap B)=P(A)P(B)其中P(B)>0P(B)>0

      • 条件独立:P(A∩B∣C)=P(A∣C)P(B∣C)  ⟺  P(A∣B∩C)=P(A∣C)P(A\cap B|C)=P(A|C)P(B|C)\iff P(A|B\cap C)=P(A|C) [5]
    10. 一组事件独立:任意两两事件且所有事件相互独立

      • 独立试验序列:重复的相互独立的试验

      • 如果结果只有两种可能称为:伯努利试验序列:p(k)=(nk)pk(1−p)n−kp(k)={n\choose{k} }p^k(1-p)^{n-k}

        • 其中(nk){n\choose{k} }为二项式系数n!k!(n−k)!\frac{n!}{k!(n-k)!},为nn选kk的组合数[6]
      • 计数法

        • r阶段的结果:n1n2⋯nrn_1n_2\dotsb n_r

        • n选k排列:n!(n−k)!\frac{n!}{(n-k)!}

        • n选k组合:二项式系数(nk)=n!k!(n−k)!{n\choose{k} }=\frac{n!}{k!(n-k)!}

        • 分割:(nn1)(n−n1n2)⋯(n−n1−⋯−nr−1nr){n \choose{n_1} }{n-n_1 \choose{n_2} }\dotsb { {n-n_1-\dotsb -n_{r-1} } \choose{n_r} }


离散模型:值域为有限个集合

  • 分布列:用pXp_X表示随机变量XX的分布:pX(x)=P({X=x})p_X(x)=P(\{X=x\})

    • 伯努利随机变量:pX(k)={p,若k=1,1−p,若k=0.p_X(k)=\begin{cases} p,若k=1, \\ 1-p,若k=0. \end{cases}

    • 二项随机变量:

      pX(k)=P(X=k)=(nk)pk(1−p)n−k,k=0,1,⋯ ,np_X(k)=P(X=k)={n \choose{k} }p^k(1-p)^{n-k}, k=0,1,\dotsb,n

    • 几何随机变量:pX(k)=(1−p)k−1p,k=1,2,3,⋯p_X(k)=(1-p)^{k-1}p,k=1,2,3,\dotsb

    • 泊松随机变量:

      pX(k)=e−λλkk!,k=0,1,2,3⋯ ,p_X(k)=e^{-\lambda}\frac{\lambda^k}{k!},k=0,1,2,3\dotsb,

    • 随机变量的函数:

      pY(y)=∑{x∣g(x)=y}pX(x)p_Y(y)=\sum_{ \{x|g(x)=y\} }p_X(x)

  • 离散分布列之间关系

    • 伯努利随机是n=1n=1二项随机变量,二项随机变量是为在nn次的kk次成功,而几何随机这是一种累计直至第kk次成功,泊松随机变量更具有现实意义,在n很大,p很小即大规模发生事件下的小概率发生事件应用[7]
  • 多个随机变量的联合分布列:

    • 联合分布并没有严格区分离散模型和连续模型,只是因为模型不一样导致计算过程不一样。

    • pX,Y=P(X=x,Y=y)p_{X,Y}=P(X=x,Y=y),其中pX,Yp_{X,Y}称之为联合分布,将pX(x)=∑ypX,Y(x,y),  pY(y)=∑xpX,Y(x,y).p_X(x)=\sum_y{p}_{X,Y}(x,y),\quad\;p_Y(y)=\sum_x{p}_{X,Y}(x,y).为边缘分布。

  • 条件:正如第一章,所有概率都会有条件和独立的问题存在。这是全概率准则的基础。

    • 单一事件的随机变量:pX∣A(x)=P(X=x∣A)=P({X=x}∩A)P(A)p_{X|A}(x)={\rm P}(X=x|A)=\frac{ {\rm P}(\{X=x\}\cap{A})}{ {\rm P}(A)}

    • 给定另一个随机变量值的条件下的随机变量:$$

    • 给定另一个随机变量值的条件下的随机变量:pX∣Y(x∣y)=P(X=x∣Y=y)p_{X|Y}(x|y)={\rm P}(X=x|Y=y)公式pX,Y(x,y)=pY(y)pX∣Y(x∣y)p_{X,Y}(x,y)=p_Y(y)p_{X|Y}(x|y),或利用pX,Y(x,y)=pX(x)pY∣X(y∣x)p_{X,Y}(x,y)=p_X(x)p_{Y|X}(y|x)

  • 独立性

    • 定义:P(X=x且A)=P(X=x)P(A)=pX(x)P(A)对一切x成立{\rm P}(X=x 且 A)={\rm P}(X=x){\rm P}(A)=p_X(x){\rm P}(A) 对一切 x 成立,如果P(A)>0P(A)>0,则P(X=x且A)=pX∣A(x)=pX(x)对一切x成立.{\rm P}(X=x 且 A)=p_{X|A}(x)=p_X(x) 对一切 x 成立.
  • 条件独立:

    • 随机变量之间的相互独立性与随机变量和随机事件的相互独立性的概念是完全相同的.[8]

一般随机变量:连续随机变量

  • 连续随机变量和概率密度函数(PDF):

P(X∈B)=∫bf(x)dxP(X\in B)=\displaystyle\int_b{f(x)}{dx}我们称f(x)f(x)为X的概率密度函数,

  • 端点无用:P(X=a)=∫aaf(x)dx=0P(X=a)=\displaystyle\int_a^a{f(x)}{dx}=0,所以区间端点的概率计算无用:P(a≤X≤b)=P(a<X≤b)=P(a≤X<b)=P(a<X<b)P(a\leq X\leq b)=P(a < X\leq b)=P(a\leq X < b)=P(a < X < b)

  • 关于PDF性质的小结:[9]

    1. 设 XX 的PDF(概率密度函数)为 fX(x)f_X(x) .fX(x)≥0f_X(x)\geq 0对一切 x 成立.且可以大于1

    2. ∫−∞∞fX(x)dx=1\int^\infty_{-\infty}f_X(x)\text{d}x=1

    3. 设 δ 是一个充分小的正数, 则 P([x,x+δ])≈fX(x)⋅δ\text{P}([x,x+\delta])\approx f_X(x)\cdot\delta.其中P([x,x+δ])\text{P}([x,x+\delta])满足概率律,所以fX(x)f_X(x)是可以大于1的

    4. 对任何实数轴上的子集BB,P(X∈B)=∫BfX(x)dx{\rm P}(X\in{B})=\displaystyle\int_{B}{f}_X(x)dx.

  • 常见分布列

    1. 均匀随机变量:即f(X)f(X)在[a,b][a,b]上均匀分布

    2. 指数随机变量:$f_X(x)=\begin{cases}

    \lambda e^{-\lambda x},若x\geq 0 \

    0 ,其他\end{cases}$

    1. 正态随机变量:fX(x)=12πσe−(x−μ)2/(2σ2),f_X(x)=\frac1{\sqrt{2\pi}\sigma}{\rm e}^{-(x-\mu)^2/(2\sigma^2)},

      • 线性变换之下,随机变量的正态性保持不变,体现在方差和期望[^12]

      • 正态随机变量 Y 的期望μ\mu为0, 方差σ2\sigma^2为1,则 Y 称为标准正态随机变量

      • 结合上述性质,可以将非标准快速转换为标准,再利用标准正态速查表进行快速计算正态分布的结果


期望,均值,方差

  1. 期望:

    • 期望:我们把px×xpx\times x称之为期望值M=E[X]M=E[X]

    • 离散期望值为M=m1k1+m2k2+⋯+mnknkM=\frac {m_1k_1+m_2k_2+\dots+m_nk_n}{k},这是期望值得原本定义,在这边假定了kk值很大,将kik≈pi\frac {k_i}{k} \approx p_i,最后得出E[X]=∑xxpX(x)E[X]=\sum_x xp_X(x)

    • 连续随机期望依据定义:E[X]=∫−∞∞xfX(x)dx.{\rm E}[X]=\int_{-\infty}^{\infty}xf_X(x){d}x.

    • 通常我们会将其看作分布列的重心

    • 期望规则

      • 随机变量Y=aX+bY=aX+b,则E[Y]=aE[X]+b,var[Y]=a2var(X)E[Y]=aE[X]+b,var[Y]=a^2var(X)[10]

      • var(X)=E[X2]−(E[X])2var(X)=E[X^2]-(E[X])^2 [11]

    • 条件期望:根据定义E[X∣A]=∑xxpX∣A(x){\rm E}[X|A]=\sum_xxp_{X|A}(x)

  2. 方差

    • 方差:记作var[X]var[X],var[X]=E[(X−E[X])2]var[X]=E[(X-E[X])^2]

    • 标准差:σX=var(X).\sigma_X=\sqrt{\text{var}(X)}.

    • 连续随机方差:var(X)=E[(X−E[X])2]=∫−∞+∞(x−E[X])2fX(x)dx\text{var}(X)=E[(X-E[X])^2]=\int_{-\infty}^{+\infty}(x-E[X])^2f_X(x)dx

    • 两者都是衡量XX在期望周围的分散程度,方差衡量标准为平方米,而标准差为米。

  3. 常用的随机变量的均值和方差

    • 伯努利随机变量:E[X]=1⋅p+0⋅(1−p)=p\\E[X]=1\cdot{p}+0\cdot(1-p)=p\\,E[X2]=12⋅p+02⋅(1−p)=p{\rm E}[X^2]=1^2\cdot{p}+0^2\cdot(1-p)=p\\,var(X)=E[X2]−(E[X])2=p−p2=p(1−p)\text{var}(X)={\rm E}[X^2]-({\rm E}[X])^2=p-p^2=p(1-p)

    • 离散均匀随机变量E[X]=a+b2,var[X]=(b−a)(b−a+2)12\\E[X]=\frac{a+b}{2},\\var[X]=\frac{(b-a)(b-a+2)}{12}

    • 二项分布式:E[X]=np\\E[X]=np,var(X)=∑i=1nvar(Xi)=np(1−p)\\\text{var}(X)=\sum_{i=1}^n\text{var}(X_i)=np(1-p)

    • 泊松随机变量:E[X]=λE[X]=\lambda,var(X)=E[Y2]−(E[Y])2=λ(λ+1)−λ2=λvar(X)=E[Y^2]-(E[Y])^2=\lambda(\lambda+1)-\lambda^2=\lambda

    • 几何变量:E[X]=1p{\rm E}[X]=\frac 1 p

    var(X)=E[X2]−(E[X])2=2p2−1p−1p2=1−pp2.\\\text{var}(X)={\rm E}[X^2]-({\rm E}[X])^2=\frac2{p^2}-\frac1p-\frac1{p^2}=\frac{1-p}{p^2}.


    • 均匀随机变量:

      E[X]=a+b2E[X]=\frac{a+b}{2}\\,var(X)=E[X2]−(E[X])2=a2+ab+b23−(a+b)24=(b−a)212.\text{var}(X)={\rm E}[X^2]-({\rm E}[X])^2=\frac{a^2+ab+b^2}3-\frac{(a+b)^2}4=\frac{(b-a)^2}{12}.

    • 指数随机变量:E[X]=1λvar(X)=1λ2{\rm E}[X]=\frac1\lambda\quad\text{var}(X)=\frac1{\lambda^2}

    • 正态分布:E[X]=μ,var(X)=σ2.{\rm E}[X]=\mu,\quad\text{var}(X)=\sigma^2.

极限理论

  1. 大数定律:所以当 n→∞n\to\infty时,MnM_n 的方差趋于0.也就是说,MnM_n 的分布大部分就必然与均值 μ\mu特别接近.这种现象就是大数定律的内容,即随机变量序列 MnM_n,从大样本意义上看,收敛于 $X_i $的均值 μ\mu .按通常的解释,当样本量很大的时候,从 X 抽取的样本平均值就是 E[X] ,大数定律就为此提供了一个数学理论基础.

  2. 中心极限定理:用 SnS_n 减去 nμn\mu ,可以得到零均值随机变量序列 S_n-n\mu ,然后再除以σn\sigma\sqrt{n},就得到随机变量序列Zn=Sn−nμσn.Z_n=\frac{S_n-n\mu}{\sigma\sqrt{n} }.易证明E[Zn]=0,   var(Zn)=1.{\rm E}[Z_n]=0, \ \ \ \text{var}(Z_n)=1.因为ZnZ_n的均值和方差不依赖于样本容量 n ,所以它的分布既不发散,也不收敛于一点.中心极限定理 就研究ZnZ_n的分布的渐近性质,并且得出结论:当nn充分大的时候,ZnZ_n的分布就接近标准正态分布.

  3. 马尔可夫不等式:P(X≥a)≤E[X]a{\rm P}(X\geq a)\leq \frac{ {\rm E}[X]}{a}

  4. 切比雪夫不等式:随机变量 X 的均值为 μ\mu,方差为σ2\sigma^2,则对任意 cc%3e0 ,P(∣X−μ∣≥c)≤σ2c2{\rm P}(|X-\mu|\geq c)\leq \frac{\sigma^2}{c^2}

  5. 通过上述四个理论,大数定理和中心极限提供了数学理论基础,而马尔可夫不等式和切比雪夫不等式则计算出来一定的概率上限。


\begin{align*}\text{var}(X)&=\sum_x\left(x-{\rm E}[X]\right)^2p_X(x)\\&=\sum_x\left(x^2-2x{\rm E}[X]+({\rm E}[X])^2\right)p_X(x)\\&=\sum_xx^2p_X(x)-2{\rm E}[X]\sum_xxp_X(x)+({\rm E}[X])^2\sum_xp_X(x)\\&={\rm E}[X^2]-2({\rm E}[X])^2+({\rm E}[X])^2\\&={\rm E}[X^2]-({\rm E}[X])^2.\end{align*}

[^12]线性变换之下随机变量的正态性保持不变:设 X 是正态随机变量, 其均值为μ\mu, 方差为σ2\sigma^2 .若 a≠0a\not=0 和 bb 为两个常数, 则随机变量Y=aX+bY=aX+b仍然是正态随机变量, 其均值和方差由下式给出:E[Y]=aμ+b,var(Y)=a2σ2.{\rm E}[Y]=a\mu+b,\quad\text{var}(Y)=a^2\sigma^2.


  1. 概率律的所有性质都在后续有应用,基于不同的模型。 ↩︎

  2. 古典模型:P(A)=含事件A的结果数nP(A)=\frac{含事件A的结果数}{n} ↩︎

  3. 条件概率也满足概率律的所有性质:P(A∣C∪B∣C)≤P(A∣C)+P(B∣C)P(A|C\cup B|C)\leq P(A|C)+P(B|C) ↩︎

  4. 试着使用现实意义进行描述贝叶斯准则:通过事目标件B在特定条件下的发生概率,来反推出事件B在无条件或者特定样本空间下的概率。即在通过结果来反推出发生原因的概率。 ↩︎

  5. 继续不是很重要的推导过程,中间用到条件概率的乘法法则:P(A∩B∣C)=P(A∩B∩C)P(C)=P(C)P(B∣C)P(A∣B∩C)P(C)=P(B∣C)P(A∣B∩C)  ⟺  P(B∣C)P(A∣B∩C)=P(A∣C)P(B∣C)  ⟺  P(A∣B∩C)=P(A∣C)P(A\cap B|C)=\frac{P(A\cap B \cap C)}{P(C)}=\frac{P(C)P(B|C)P(A|B\cap C)}{P(C)}=P(B|C)P(A|B \cap C) \iff P(B|C)P(A|B \cap C)=P(A|C)P(B|C) \iff P(A|B\cap C)=P(A|C) ↩︎

  6. 组合数即意味着含有次序 ↩︎

  7. 试图证明泊松变量和二项随机变量的逼近:设n→∞,p→0n\to \infty,p\to 0, 且np=λnp= \lambda将二项随机变量:$$\begin{align*}\frac{n!}{k!(n-k)!}pk(1-p){n-k}\end{align*}中中n=\frac{\lambda}{p}得到只剩下得到只剩下\lambda的式子,求极限。总结下对应意义就是在试验次数的式子,求极限。总结下对应意义就是在试验次数n很大的情况下,很大的情况下,p很小,则无限接近二项随机变量。现实意义就是:如果大规模事件出现小概率事件的次数很小,则无限接近二项随机变量。现实意义就是:如果大规模事件出现小概率事件的次数k$,可以参照二项式进行快速计算。 ↩︎

  8. 随机变量 X 和 Y 称为相互独立 的随机变量, 若它们满足pX,Y(x,y)=pX(x)pY(y)p_{X,Y}(x,y)=p_X(x)p_Y(y)对一切 x 和 y 成立.这等价于对于任意 x 和 y , 随机事件 X=xX=x和Y=yY=y相互独立. 最后,由公式 pX,Y(x,y)=pX∣Y(x∣y)pY(y)p_{X,Y}(x,y)=p_{X|Y}(x|y)p_Y(y)可知随机变量 XX 和 YY 的相互独立性的条件等价于:pX∣Y(x∣y)=pX(x)p_{X|Y}(x|y)=p_X(x) 对一切 x 和一切满足pY(y)>0p_Y(y)>0 的 y 成立.直观上, Y 和 X 的独立性意味着 Y 的取值不会提供 X 取值的信息.在给定事件 A 的条件下(P(A)必须大于0!)({\rm P}(A) 必须大于0!)也可以定义两个随机变量的条件独立性.在给定事件 A 的条件下,所有的事件的概率都换成关于条件 A 的条件概率. 例如, 我们称随机变量 X 和YY在给定正概率事件 AA的条件下是条件独立的 ↩︎

  9. 满足概率律 ↩︎

  10. 试着使用重心理论去理解,图像的增大和缩小会影响其重心,和XX与重心的距离,但是左移右移不影响两者距离,只影响重心位置。 ↩︎

  11. 依旧不是很重要的证明过程:直接使用定义法: ↩︎

《Python的数据科学手册》

这本书和我之前看的《数据科学入门》,《数据科学导论》其实都大差不离,数据科学的基础不在于python的操作,而是算法的不同,这本书的最后一章也是在重复的讲述那些算法。但是还是一样的问题,他的算法解释都是基于自己创造的数据来着,和实际场景有着千山万水的差别,总归来说,你没办法拿来主义的应用了。

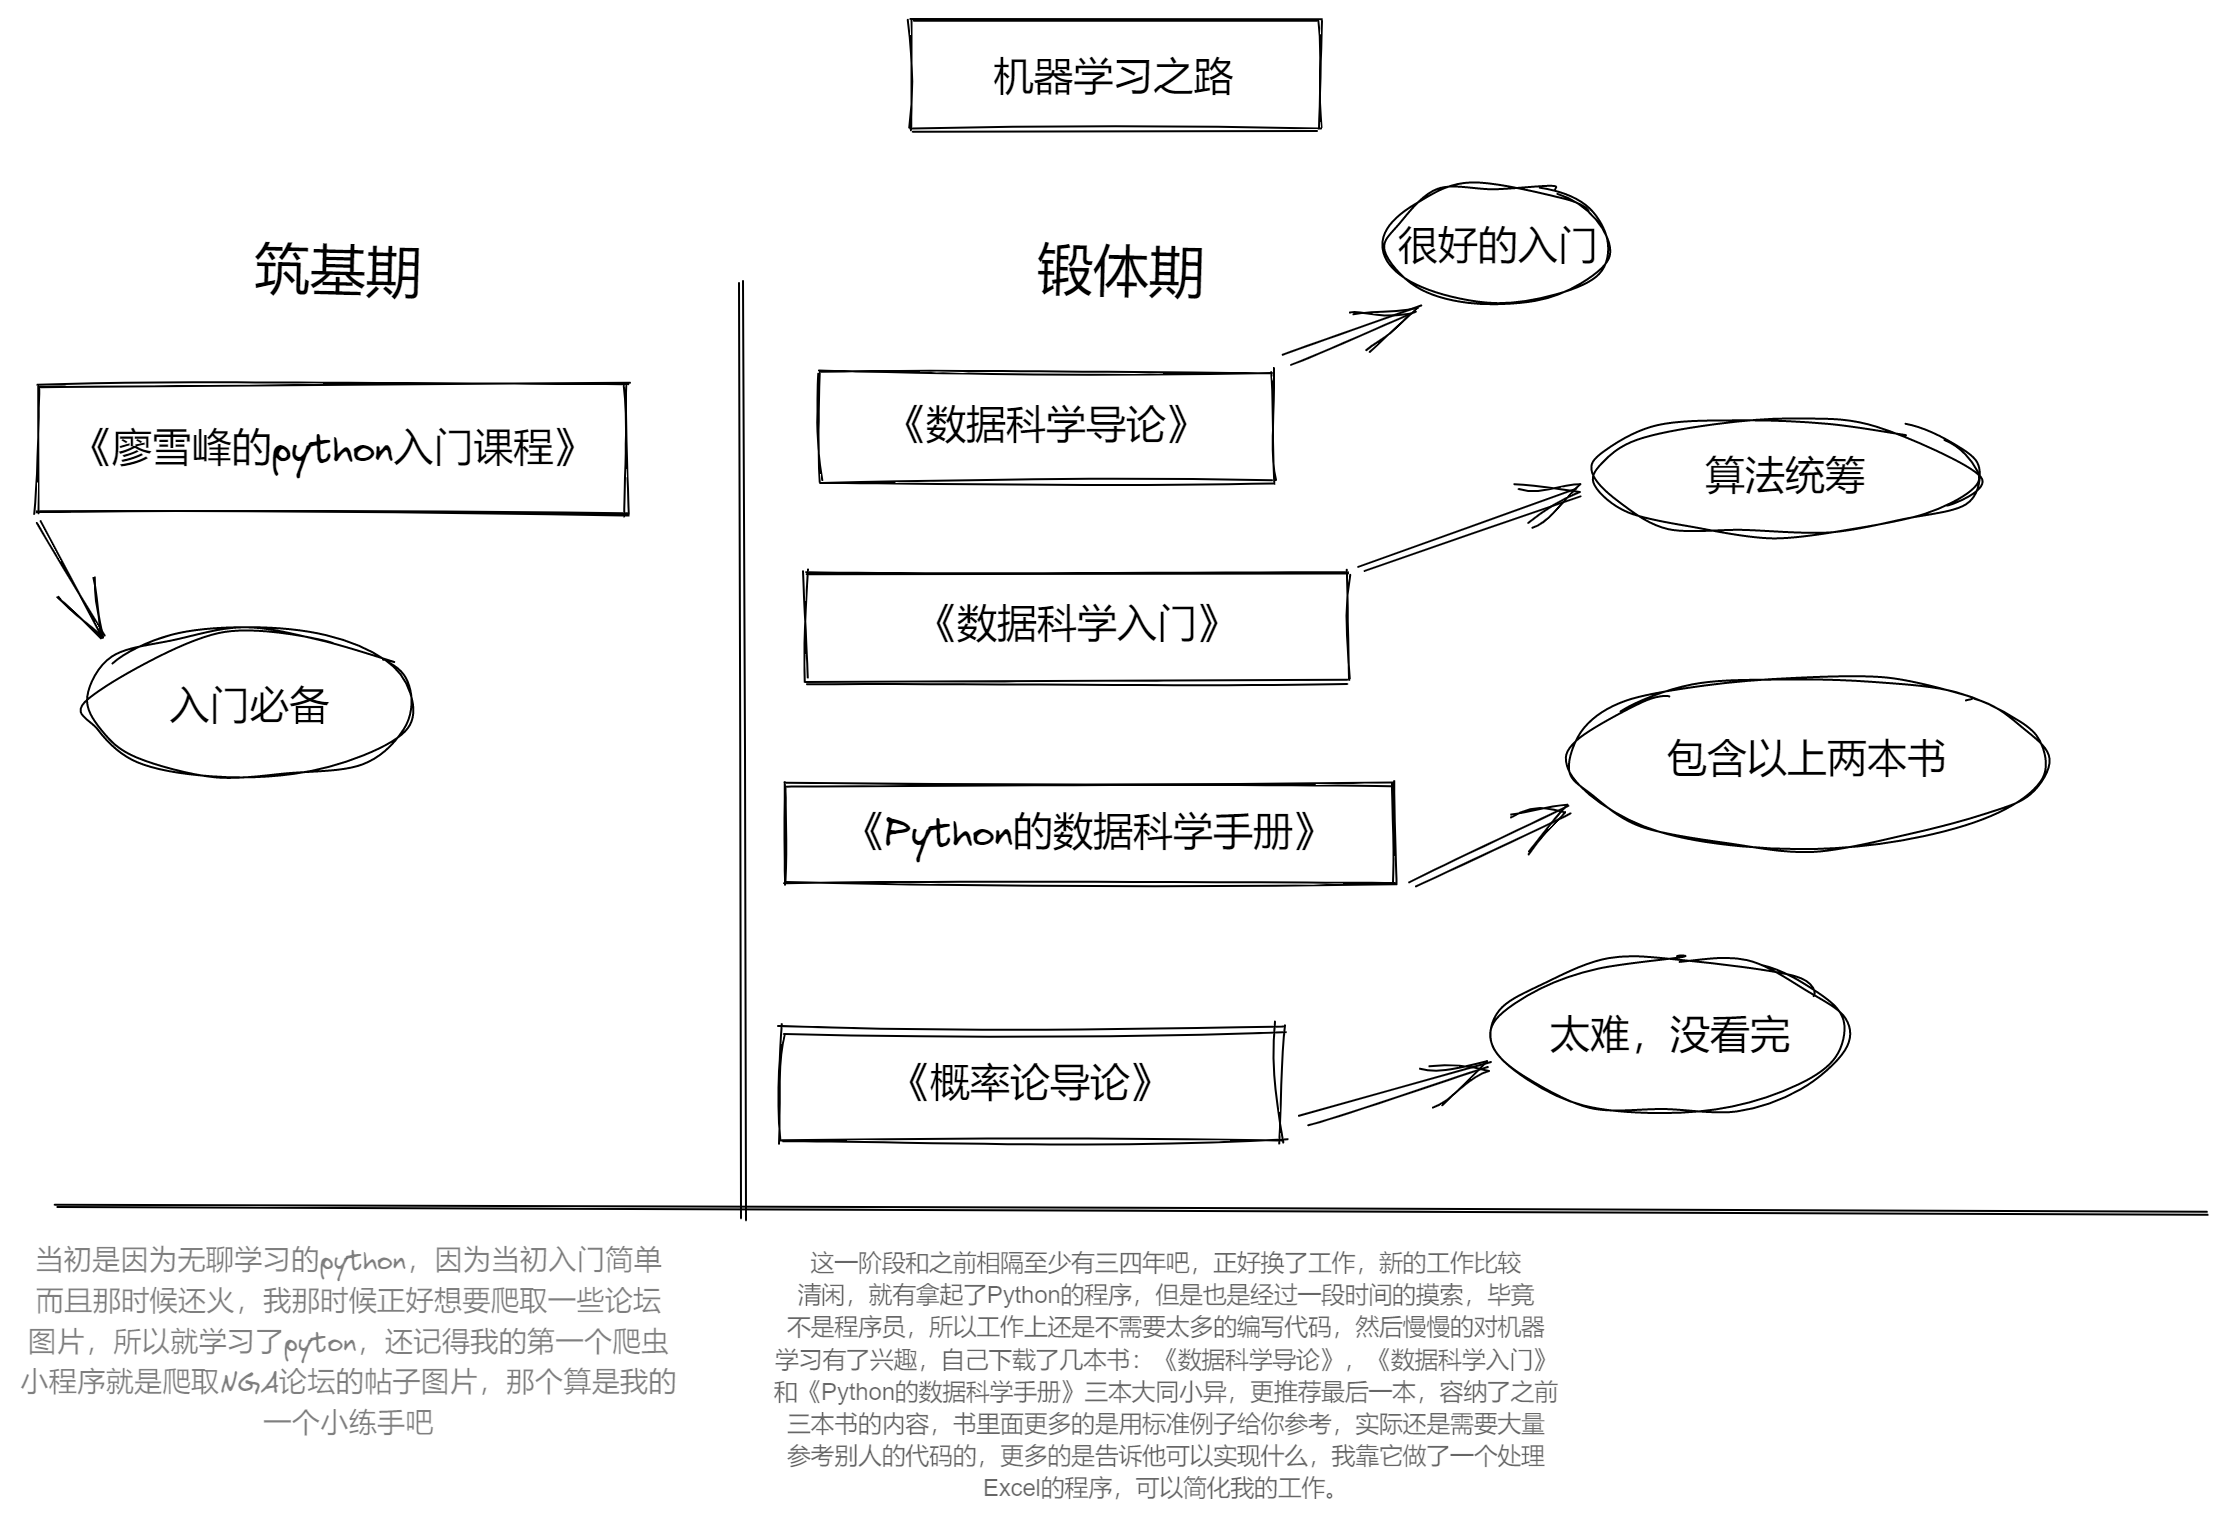
看了这么多,现在也差不多可以来谈谈自己对机器学习学习过程的一些经验推荐了。

首先是python操作,这里我建议直接看《廖雪峰的python教程》网页上就有,跟着学习,打打代码,知道python的一些操作逻辑即可。无论是这本书还是接下来的书,更多的是入门,就是告诉你python有那些用处,但是它不会全面,仔细的告诉你,因为实际情况下每个业务环境都不同,就像我们以前学习SQL语句一样,看着学的是selcet,from这些简单的,但是它给了你一些衍生,允许你在需要更高级的操作时候去再次学习,然后不断加深自己的技巧,而机器学习和python操作一样,都是一个简单入门,然后你实际业务操作时候还需要大量的去查找资料,所以每次学习完成之后你都会觉得看起来没学一样,你需要大量的习题和现实业务来不断的磨练你的技巧。

好的,基于以上原因《数据科学入门》,《数据科学导论》和《Python的数据科学手册》这三本书,你完全可以选择一本看就可以,推荐的是后面两本:《数据科学导论》和《Python的数据科学手册》都是O’Reilly精品图书系列,它出版的书确实都是具有一定科技前沿技术的。所有书的结构其实大同小异,前面都是讲述Python的安装,然后是nump包,pandas包,最后就是sklearn包,然后就是各个算法的实现,它没有体现各个算法实际过程,你就如同盲人摸象一样,慢慢的摸索,按照它的代码看着一张张美丽的图片出现,你甚至有点削足适履,将你的数据转换成它想要的格式,然后再进行学习计算。但这一过程是必备的,我们需要了解这些程序能够接受什么样的数据,然后再进行自己的推断和思考。

但是这些书也是有不足之处的:他们很多时候都是只谈及他们经常用到的一些用法,而且数据结构简单,所以到了你实际操作的时候你还是需要一个速查表,或者别人的代码操作来实现自己的想法,正如上面所说的,这就是一个入门。它告诉你工具如何使用,但是不告诉你工具原理,但这一切又是必要的,知其然然后知其所以然。

对此我的学习建议是跟着写代码,然后理解他的意思,最后再应用在自己的数据去。期间可以简单的应用在自己的工作中,比如我就拿了Pandas处理了日常excel的数据。方便自己导入到出纳系统。

机器学习之路3

接下来我考虑学习具体的解析过程:算法的数学过程。很多时候面对的是不断累积的数据,我却没有一个比较好的思路对其进行处理,很多算法我只是知道其如何使用或者是分类算法,还是近似算法。这边推荐《白板推导》视频B站里面有,讲的不算深,他侧重不在于计算过程,而是整个概念得理解过程:比如不同角度理解线性回归等,所以不需要你会实际的操作或者计算,很多时候只需要理解概念即可。比如我虽然不会矩阵求导得方法,但是我知道他求导是为了求出极值,那么这就够了,足够我们继续学习下去了。

然后根据白板得推荐,有几本很好得入门书籍可以值得阅读:

《统计学习方法》

PRML《模式识别与机器学习》

MLAPP《》

《统计学习基础(ESL)》

《deep learning》

视频:

台大-林轩田

《基石》VC,正则化,线性模型

《技法》SVM,决策树,随机森林

张志华:纯数学推导

《机器学习导论》频率派

《统计机器学习》贝叶斯

台大:李宏毅-机器学习

这些书和视频后续会找时间了解下。

同时我也会练手几个项目,防止自己编码生疏。


20220720140826

书不长,很容易读完。讲的是我们以前看过没看过的小说分析。作为一个作家也是一个中文系的教授,毕飞宇看待小说的角度和方式与我们有差距。所以这本书是用如果你是一个中文系学生或者一个教授来看小说:你会怎么看。

虽然说是解读小说,但是其实涉及面很广。从最基本的人生哲学,到日常的生活道理。小说,文学之间的差距,然后就是解答了一个很多人关注的问题:你解读一个小说是不是过度解读。作者回答的很到位:不是,作者写作的时候要考虑的很多,好的作家的书是有自己的内在逻辑的,这套逻辑也许连作家自己都没发现,所以需要我们这种外人去给他挖掘和解读。这让我想起了当初高考那只泛着绿光的鱼。甚至乎有人问韩寒他写作的时候是不是真的有这么想。我接受这个答案,很多时候小说或者说文章的脉络是一气呵成的,你若让我回想当初的逻辑,我也是一时堵塞,甚至如今翻看我之前的文章,有些我甚至觉得这是何德何能出自我手的文章啊。就是这样的一种感觉。虽然写有这本书,但不代表你对这书,这文章有唯一的解释权,它是你的,但又不全是你的,人们可以从中获取到自己想要的内容,而不必和你一样又相同的感悟。文学从来都不是分享自己的情感,它可以干很多事。鲁迅拿他来鞭策我们的国民,汪曾祺拿它来表现出文人的雅。不同的人写的文章是不同的,这还没算上那些上不得台面的,见不上报的小博客。

看完这本书的第二个所得就是得到了一大堆书单,虽说这书里解读的小说都是古今中外的文学名著,但是奈何当初年轻不懂事,要么没读过,要么没读懂。所以就像书里说的一样:有些书四十岁之前读和四十岁之后读是两种不一样的感觉。如今我三十了,就当作四十吧。我准备重新读读那些读过和没读过的书。这次试着认真的读懂这些书。可笑的是前段时间才刚刚读完余华的几部小说,现在想来,也算是没读一样,也写下来洒洒长文,但是总没有像书中的那样,让人回味,让人咂舌。是读的太快没读懂,还是余华写的白。

人到了三十,就想着出人头地,就想着赚钱。人人都在说三十五岁就定型了,三十五就没法跳槽了,三十五身体就慢慢的不行了。现在的我按人人说的正站在那鬼门关前。在门口本来没有什么,但是看着这门,内心总是耐不住的焦急。看不下这些闲书,想得是今日读到一本好书,明天就根据书上得内容,大发横财。你说让我慢慢得欣赏这小说,看不进去。还不如去看《概率论》好歹以后万一可能用得到呢?年纪越大倒是越耐不住啊。

静下心想想:也不是没有一技之长,只不过这社会大家都是多才多艺,你这一技之长总是稍显弱势,半路出家学点啥呢,又觉得不如人家正规军学的透彻,规范。所以不免就陷入了焦躁。想着转行,但是学不进去,总归一句话:是对现在得生活烦了。就这一亩三分地,就这半吊子得学问,再学也就那样,没法实现阶级的跨越,更多的是给本可以安分下来的生活多来点水花。看着那些荡漾,心里就舒服,生活在于运动。研究生,博士生的精髓就在于钻研,钻研某个学问,但是我钻不进去,我看了快2个月的《概率论》看的我是云里雾里,虽然看得懂,但是一到做题就显得头大,它教的和它考的是两回事。后来慢慢的也就放弃了,看看书,能理解应用就可以,至于刷题,还是算了。我注定是钻不进去那个门道。好赖多学一点知识,当个业余爱好也是不错。别人业余爱好都是养鱼赏花,我就喜欢写点文章,写点代码。看着那一串串的数据,我舒服。然后数据再删减规范,我就更加的痛快了,等图表整齐规划之后我也就射了。然后剩下的就是贤者模式的思考:我花了这么多时间做了些什么劳什子。

工作和兴趣的不统一算是目前现状,我的工作不需要这些代码,或者说这些代码没法让我发财,如果让我变成一个专门写代码的,我估计也开心不了,因为我的代码还是没法让我发财。总归就是要发财。其实心放宽,发财的机会不能说是没有,我不能自己把希望湮灭,姑且安于当下,看看书,饮饮茶,一本书看完,有所得,那就是好的。这本书看完,所得颇丰。

20220712145919

写在前面:

  1. 翻译很重要,这本作者是德国,然后被人翻译成英文,再翻译成中文,所以翻译很重要,不仅如此,以后所有的外文书籍都要关注下翻译质量,不行多下几本电子书对比。我一开始看的完全是狗屁不通的机器直翻。

  2. 这本书的脚注完全不建议去看。尤其如果你只是像我一样想要了解内容的读者,完全没有必要去看。作为一篇论文,本文的脚注大部分是文献的引用,其余的也是作者和别人的争辩。如果你不是专业人士或者资深爱好者,你会对他们的争辩内容感到迷惑,所以建议看原文就可以,脚注完全忽略,而且不会影响你理解的。

  3. 也许是我下的电子书版本问题,或许这种论文内容太少的缘故吧。我这本书一开始导言,然后是导读,导论,绪论,序言。最后才是正文。当到正文的时候书本内容已经接近一半了。这里并不是吐槽书本注水,相反,前面的导言导论对我们理解书本内容有很大的帮助,甚至可以说,如果你只是前来观瞻一下这部伟大的著作的话。那么只要读完前面的这些即可。由于时代背景和专业背景缘故。你观看正文的理解也许还没有前面的导论清楚,而且这是部宗教论文,所以很多时候提及的很多重大事项变革并不是为我们所熟悉。所以导论,导读可以帮助我们理解。

20220702100534

哲学?不,是宗教

很多人会把这本书奉为一本哲学著作,然我并不是什么哲学家,更多的是对人性有着自己的思考。人性和现实之间存在着一层隔阂,人有时候会无法在社会生存。人类对自己的欲望或者需求的了解知之甚少,虽然从很久以前就已经有了内省,更多的人却无法了解自己,很多时候自己的直观需求和大众认知存在着明显的差距。那这种情况下是以什么为准,是极端的自我主义还是为了大我放弃小我的伟大奉献抑或是更加现代化的责任义务划分呢。我对当代社会的矛盾很多时候觉得不是主义之间的矛盾,而是个人和群体的矛盾,西方自我思想的侵入或许是人民心智的成熟,越来越多的人感到对社会的不适,我们996,我们007,我们丁克,我们不婚。我们内心需求的是一亩三分地,老婆孩子热炕头,但是生活却是地下室,接盘侠,6个钱包。我相信政府或者说那些先驱的梦想中的光景并不是如此,但又是什么让我们陷入如此田地呢。我不否认个人的作用,但我想在大势之内个人的作用微乎其微。很多时候祖国,民族,甚至家庭所裹挟,在大众道德的观念影响下,我们做出了一些违背甚至损害自我利益的行为。这就是伦理的力量。而如今社会发生的这一切难道不是和书里所描写的如此相像:我们也正在经历一场清教徒式的伦理改革:对名利和金钱的追求变得前所未有的赤裸,如果追求不到,那么再极端的调转船头,成为一个抛名弃利的清高之人,然后再通过这遗世独立的人设,换着法的追名逐利。任何以抛弃名利的行为最后都会称为名利。我们在始终在这看不见的名利场内。

宗教?不,是人生

我们逃不出,摆不脱,追不上名利,却只能在这白皑皑的世间,给人当着垫脚的石子。人活一世,究竟室为了什么:为了功名,为了声望那个,还是为了钱财。生而为人,却不知前路在哪,说的是行行出状元,条条通罗马,但是哪个不是人中龙凤,哪个不是名师辅佐。十四万万之人又有几人能飞升得道,又有几人能静心苦读。人的痛苦一目了然。人类苦于自己的欲望和通途之间的矛盾,需要寻求另外一种更加容易达到的解脱,于是这种廉价且易得的道路出现了:宗教。或许有些人说,随着科学技术的发展慢慢的这些迷信会渐渐式微。如果说早期的萨满教等古典宗教解答的是人类对自然的无知,如今的宗教解决的是人类自身的需求:需要追寻自己来这一趟的目标是什么?诚然,自我强大之人能在自己人生的道路上慢慢找到目标,但是更多碌碌无为之人,却是终其一生不得其宗。宗教的存在有其意义,如今的宗教依旧存在,他给与人目标,让他们更加潜心学习,实现自己美好的生活,而跳过了那追寻的过程。但是宗教并不是这个问题的唯一答案,只是众多答案之一:父母的耐心教导不失为另一种答案。

人生?不,是上帝

书里面拿了基督教作为案例。基督教其实是有很多分支的,分支的原因在于两点:1. 哪个版本的《圣经》,2. 怎么解读《圣经》。语言的歧义和不断进化这些特性,导致我们对古代文献的解读在各个时期是不一样的,姑且不论各种宗教的差异,在书里主要是通过对新教这一基督教分支进行分析,这也是这本书的书名由来。根据新教的教义:大多数的人类都是不值得救赎的,只有一小部分人类是可以救赎的,而这一小部分是由上帝确定的。在这种教义之下,教众很容易就会陷入一种宿命论的牢笼,既然我注定要下地狱,那我又为何要好好的过呢。

对于加尔文来说,上帝的decretum horribile(可怕裁定)并不是像路德认为的那样来自宗教经验,而是出于他自己思想的逻辑需要。因此,随着他的宗教思想越来越具有逻辑一致性,decretum horribile也越来越具有重要意义。它唯一关注的是上帝,而不是人;上帝不是为了人类而存在的,相反,人类的存在完全是为了上帝。一切造物,当然包括加尔文深信不疑的事实,即只有一小部分人能被选中而得享永恒的恩宠,它们的全部意义就在于体现了上帝的荣耀和威严。以尘世的公正标准来衡量上帝的最高旨意不仅毫无意义,而且是亵渎上帝,因为上帝是自由的,而且只有上帝才是自由的,就是说,上帝不受制于任何律对于被罚入地狱的人来说,抱怨自己的命运不济,差不多等于动物抱怨它们不曾生而为人,因为肉体的一切都与上帝隔着一条无法逾越的鸿沟,只要上帝还没有为了自己的荣耀而做出其他判决,人就该当永灭。我们所知道的只是:人类只有一部分能够得救,其余都被罚入地狱。如果认为人的功或罪在决定这种命运时会起到一定作用,则无异于认为上帝绝对自由的旨意会因为人的影响而改变,而上帝的旨意又是永恒确定了的,这是于理不通的自相矛盾。

在极致的悲观下,就慢慢引申出了另一种教义理解。都是一样的被抛弃者,我们也是要有当抛弃者的作用的:我们如火柴一样,燃烧自己仅仅是为了上帝在人间美景的繁荣。按照如今的观念来看,也许这完全是一个妥妥的邪教主义,但是宗教的本质就是宣言恐惧,然后利用救赎扩张,利用人性的弱点和贪欲。如果好好引导的话也确实能够控制住一大群人:在这个教义的影响下:人们压抑自己的欲望,开始进入了一种打工人的模式,甚至连邻居都不交往:简单的人际关系,按部就班的工作模式,让人类摆脱大多数的烦恼,于是就有人认为这是救赎的象征——即使教义写明救赎没有任何象征,但这并不影响他们的想法,于是就更加虔诚的投入。这一过程产生的财富得以保留。和以前的商人最大的不同就在于此,他们没有将财富花出去,成为一个循环,而是留在手里,慢慢的积累。而这正是资本主义的精神:利润。

这一过程改变了很多:1,人们对工作的态度,人们不再厌恶工作,反而更加喜欢工作,认为这是救赎的方法。 2,产生的巨大财富使得形成垄断组织或者资本寄生虫得到可能,以前是赚的多,花的多,现在是赚得多花点少。3,人们对薪酬的态度,苦修式的人们生活对救赎有所裨益,所以不需要太多工资,资本家可以截取大量的利润。

这一精神下,让资本主义慢慢的走到了如今的地位,在这一内核下,资本主义需要实现的就是:更高的利润。而至于这些年产生的技术进步,则更多是为了产生更高利润产品的夫家活动罢了,工人不会因为生产高利润的产品而获得更多薪酬,产品和他的制造者以及生产资料三者完美的划分开了,每一块都只需要支付最合适的价格,从而实现资本主义最高利润的目标。更恐怖的是这就意味着,资本主义的未来不是人类的大一统宇宙,不是星辰大海,而是一个个虔诚的教众,技术进步只是其实现目标路上的工具而已。事实上,没有一个哲学思想将全人类的未来当作方向,更多的都是实现其心目中乌托邦的工具罢了。如果有一个东西能让我们成为一个个虔诚的教众,那么到那个时候,既不需要星辰大海,科学技术这些华而不实的东西了。而那个东西他已经来了

上帝?不,是消费主义

资本主义初期,人们发现我们可以通过增加产品的技术或者功能来获取更高的利润,于是就产生了专利,技术研发等等,但是技术研发投入太高而且还有失败的风险,技术推广也需要很长时间,所以,慢慢的这一套已经日渐失落了。现如今,资本主义已经进化成了消费主义:不再创造一个统一宗教的虔诚教众,而是创造千千万万个宗教的虔诚教众:奢侈品教众,轻奢教众,联名教众。只要宗教够多,那么就会将所有的人都划分进来,无论是是男女,LGBT,甚至猫狗都可以。这一套成本投入少,附加值高,起效快,已经成为了新一代的资本主义

消费主义从人和人的差异中创造价值,无论是性别,身高,取向,财富。他从一个虚无的空间里拿出了一把尺子,将人和人划分到一个个不同的圈子了,每个圈子都能源源不断的产生金钱,甚至圈子和圈子之间碰撞都能产生金钱。人类的思想就这么在现实中得到了体现,这算是人类踏入虚无主义的第一步吧。

我甚至无端猜想:如果有一天,圈子不再产生利润了,那么人类的社会会是怎么样?是大家都和谐统一,对任何事都有一样的看法了。还是圈子破裂,大家四散开来,再也聚不到一起。

有人说:人类的思想是无穷无尽的能源?那不过是诗人们的一厢情愿罢了,人都有价值,人的思想也是,不过也是金钱罢了。如果真到了耗尽思想的那一天时:人类在耗尽的物质,又耗尽了思想,那么还剩下什么呢?

我似乎对机器有着别样的迷恋,就像一个中年大叔一样,不断的折腾着自己手上仅有的电子产品,哪怕它没有问题,哪怕它已经符合你的需求。似乎要在它身上夺回自己对生活的控制力。最近的一次折腾是上周末花费了两天不断的折腾我的红米RM2100路由器,从一开始的毛子固件刷到C大的固件,再刷牛奶猫的固件,一遍遍的刷,一遍遍的测试。其实我对我的需求特别清晰:翻墙,速度快,信号好。但是心中总是还会有那种占着便宜的思想作祟:如果能带下载那就不错,如果还可以超频那就更加完美。我对电子产品的需求和期望就是在这些超频,多余的性能的词缀中慢慢的提高,最后到达了红米路由器到达不到的地方。于是就想着买台新的设备。

不知道是消费主义的话术,还是人的欲望。我总是希望自己的电子产品是最新版本。即使有时候你体验不出差距,但是你也愿意折腾,如果没有生活制止我,我有可能一辈子在更换版本中渡过,我想知道每个版本的异同,也想测试每个版本的表现。我看不到版本之间的差距,我希望看到他们实际表现得差距,那是一个可以耗费我大量时间,提供一点点数据,吃力不讨好得事情。但是我却异常着迷。我沉迷其中,难以自拔。我享受那段时间得专注,它在一步步建立我对这个事情得逻辑,不是通过阅读,不是通过习题,而是通过我对它每一次得微小调整,然后它表现出来得结果之间得关系慢慢建立起来得逻辑。无所谓对错,也许这就是远古得人类了解万物得过程吧。只不过现在这个过程早已被人参悟,那人写下长长文字,希望我们能从那些文字中感受到他当时得专注。

我并不是在吐槽现如今得学习方式,只是在反思自己的欲望既是如此得让人难以满足:如今我有一台电视,所以我希望有有一个东西能使它利用起来。虽然我并不喜欢看电视,偶尔看看电影。然后就是我有一个200M得网络,我希望它能像黑奴一样,没日没夜得工作,哪怕我并未从中获取半点收益。我就是这么奇怪,对于这种长期插电得物品,我总是希望它能做的更多:下载,上传,当网盘。但是我并没有这些需求,很多时候我是伪需求:为了一顿晚饭,我需要从众多频道中选择一个,哪怕我只要吃五分钟。为了让NAS下载,我会去下载一些我根本不感兴趣得电影,然后再耗费大量得时间去欣赏那部烂片,即使在线就可以看到。我似乎是在获取,拥有这些电子信息,来弥补我内心得空缺,来填补我现实得贫瘠,我得现实中有着90平米得房子,但却没有东西填满它,于是我就想要买东西,但是大型,太贵的东西又买不起,只能在电子产品上花些功夫,洋垃圾上几经筛选。NAS风正盛的时候,我确实还有一些存储得需求,照片在换手机之后没有备份,通讯录,以及一些想看得电影在线只有1080P等等。但是随着后来慢慢发现这些对我来说可有可无得,我对照片并没有太多的眷恋,毕竟没有多少过去。通讯录得人数不多,大家都是微信聊天,而电影:1是看的少,2是我的电视也只有1080P,也是一团黑。所以并没有太多需求,毕竟这是一条长长得消费链,我希望靠一个产品来解决并不现实。当初还想过组个7.1声道得家庭影院,现在想想:我连音乐都不听得。再好的音响就和现在的电视一样,摆设罢了。

如今沉静下来,认真的考虑一下自己的需求:

1. 翻墙:目前用的是电脑的软件,所以电脑端完全没有必要,手机端由于公司网络或者在外自己网络,所以手机也是常开软件,所以路由器翻墙对我来说没有刚需。

2. 内网穿透/外网访问:之前使用wordpress的话,由于vps性能不足,所以考虑过在自己NAS上,然后穿透进来或者发布出去,之前也折腾过,但是效果不尽如人意,所以目前使用轻量级博客之后,这些需求也就慢慢的消失。

3. DNS污染:这个算吧,主要是我目前图床在GitHub上,所以有时候会缺图,而翻墙有时候又看不到,目前用Smartdns,通过大量的上游服务器来抵抗DNS污染,算是解决这个问题,而且性能占用不大。

4. 下载:我已经很多年没有下载的习惯了,那时候看电影下载然后本地看,现在一般都是网页直接看,除非是老电影或者一些冷门电影,但是随着自己越来越跟随大众,这种需求也少了不少,虽然有时候在JAVBUS论坛上看到一些资源,但是根据之前的经验下载下来之后往往都是一些小片段,提不起兴趣,所以下载这个需求也就慢慢消失。

5. 电影:有,但是少,目前电视是1080P,没有4K,没有低音炮,啥都没有,一套下来估计要大几万,也没有心思和钱财去折腾,如果实在想体验,那么就去电影院体验一下吧,家里的总归有点差距,更多的是想要感受下那种感觉,执念罢了。

6. 存储:早几年也许还有需要云端同步备份的需求,现在1年40上车Onedriver,也就没了。

如今沉下心来,目前的状态是最合适的,没有过多的产品扰乱我的心,至于我一直心心念念的想要买一台正统的2盘位NAS,想体验最新的N5105的CPU。现在想来买来也是吃灰,更多的是无用,然后浪费自己大量的时间刷系统,再去下载,看电视,陷入了消费主义的虚幻之中。我一直想要组装一台自己的电脑,从零开始。更多的是弥补自己一直使用笔记本的不甘吧,出新品之后台式机就可以更换新品的CPU,显卡。而笔记本却只能马上降价,落伍。然而现在的电脑性能是超过大多数人的需求:无论是游戏还是办公。很多时候我们只不过是被新品那标注的提升20%,能耗降低等等让人浮想联翩的话语说魅惑。单就电脑而言:目前的需求是满足的:一台完美的轻薄办公本。而我躁动的心则是由长久不用的电视,空落落的客厅,闲置的遥控鼠标给与我的无形压力,我为了将这些东西用起来,所以想买一台NAS。

抛开自己来看,忽然能明白为啥那么多人在论坛里面发帖表示自己在捡垃圾,用最小的预算或者一些矿渣来实现NAS的需求,金钱往往不是最终目的,因为他们折腾的过程花费的金钱并不少,而更多是一种心态。而这种心态的形成:有对生活的不可控,有对物品的占有,也自己金钱观的体现。是一个复合的心理表述,反馈到现实是:单身,独居或者有不被认可的地方,造成了一块心灵空地,需要填补。而且具有领地意识,注重隐私,更加注重信息安全。经济上处于矛盾的节点:不一定是经济贫困,更多的是话语权不高,自己的主观意识和客观条件矛盾。他们追究的不是结果,是过程,而完美的结果是他们的目标。这个过程会让他们暂时忘却自己的现实,然后沉浸其中,而为了让这个过程更加的漫长:他们会创造出更多的伪需求来是完美的结果更慢的到来,到了最后,哪怕就是思考这一方案的实现模拟,都能让其获得满足,更加沉浸其中。

解决方法其实很简单,从你的日常生活中查起:如果一件事情需要你日复一日的做,而你又对它不厌其烦的时候,那么这时候的需求就是对的,比如之前我的笔记本电脑电源,我每天都需要拔下公司的,再带到家里,然后再带到公司,所以最后我买了一个电源,就放在家里,我就不需要反复插拔我的电源了。而我日常生活中,看电视是稀少的,大多数时候是拿来玩SWITCH的,所以我的电影需求几乎可以忽略。很多时候我会陷入一个执念之中,我希望借此剖析它,借此更了解自己和心里。

炉石传说

和麻将一样,炉石传说也具有麻将的一搬特性:特定数量的棋子数,随机的战斗过程。相较于炉石不同的是,麻将追求的是一个特定的组合,但是炉石则更复杂,是追求的是比烂,你不一定要达到完美的组合,但是你只要比其他几个好就行。而且对战过程的随机性使得运气成分占据一定的地位。

初期

在初期酒馆战旗确实可以算的上是可以和麻将并提的一个游戏,两者具有一定的相似性,那时候酒馆的版本答案:战狼瑞文,跳操海盗,剧毒鱼人,鸡杂圣盾,恶魔机枪。几乎每个种族都有一个自己的独特套路, 大家都能记住,并且在搜索的过程中慢慢接近,虽然结果并不一定是完美的版本答案,但是就如同麻将过程一样,大家是有目标。这是一个慢慢探索和逼近的过程,而对于对方大家也知道它的终极形态,可以预防,甚至早早的做好准备。游戏的竞技平衡性尚在,而提前做好准备更是体现选手对每个形态的理解和对策。

稳定期

游戏在过程中不断的优化,有时候会删除某些过分强势的组合:铜须,巨壳龙。这样,但是万变不离其宗。抛开英雄技能,很多时候一个种族只有一条出路,所以中间很多时候确定最终组合往往就是对应组合的核心出现,或者对应种族核心出现。虽然某些组合的削弱,但是由于对战的随机性和克制的随从存在,也并不是无解的地步,尚且没有出现一个巫妖王。哪怕你是完美跳操也有可能被别人圣盾机器人挡住。

疯狂期

不知道是出于什么考虑,炉石在22.0更新了酒馆伙伴。酒馆伙伴带来了肉眼可见的疯狂。很多时候一个英雄技能就能决定比赛的胜负,输赢的关键已经不是战斗的随机性和随从出现可能性。三连次数的增加降低了核心的获取难度,身材的无限扩张减少了战斗随机性带来的意外。很多时候身材无限大,三连无限多,唯一限制你的是时间,你只想加快进入下一个随从选择期,战斗过程完全不顾,各种几乎不可能实现的自动流派出现在平常人手里。那是酒馆最为疯狂的时期,但是对普通人来说也是最舒服的时期,那段时期只要你玩,你就有可能选到强势的英雄伙伴,选到牛逼英雄技能,剩下的就是爽,哪怕最后没有获得胜利,你中间的巨大操作量也使得你感到满足。但是这些完全毁坏了游戏的随机性和平衡性。很多英雄都有对应的操作。从对随从的特定组合变成了对英雄对随从组合的双重考验,满足其一即可舒服,都满足则大概率吃鸡,所以对游戏的理解又一次成为了重中之重。但是平衡性的缺失导致了8人游戏5-7人坐牢。本来游戏中间30秒后期100+秒的等待时间在之前被人诟病,现在如果是垃圾英雄,完全就不想等待这60秒,而对于某些英雄这60秒,却像黄金一样珍贵。

无趣期

或许是因为在疯狂期数据不好,或许是觉得完全不管平衡性也不合适。反正酒馆在23.0移除了伙伴机制,回到了之前的稳定期,同时带来了新的随从种类。从之前的6+野猪人+娜迦到8种随从种类,这个本来没什么,但是随着随从卡池轮换,6-8带来了质变。以前6选5,一种不见,大家还能接受,现在是8选5种,三种随从不见:第一带来的是用户本来想这局或者这个英雄玩什么种族,或者就是刚刚看到一个新套路,过来测试学习的,但是这局没有。其次是种族克制,跳操需要机器人克制的时候没有,龙人克制圣盾的时候也没有了。虽然有替换,但是增加了门槛,玩家不会去自责自己没有想出答案,只会责怪游戏。还有就是随从池的扩大,很多无用或者需要配合的随从增多,过多的讲究随从之间的配合,导致一旦我们出现一个核心随从,我就需要对应的随从进行配合,否则这个随从就是辣鸡,从身材到功能都是。但是这时候要么是自己已经靠近别的,要么就是对应随从一个都不出,因为池子里的怪增多了。这又加剧了普通玩家不满,很多时候我们只是过来玩一局放松放松。不是过来读研究生的。然后就是15血保护机制:本来是保护防止过早被那种运气爆棚的人前期带走,现在别人利用前期保护,快速升级到5-6。利用前期丢失一定量但是不致死亡的血来获得早期高级随从。一旦获得高级随从,从身材,从配合都有了更多的选择性和更好的成型。在15血保护的前几回合大家疯狂赌博,将随机性增加到了一个不属于它的地位。而15血保护机制的消失,又会让游戏加速结束。之前由于保护机制拖慢的游戏进程,在结束保护之后第一回合快速显现,很多时候一回合可以淘汰掉一半的人数。这带来的巨大体验落差。很多时候我们不仅要等待无聊的选随从时间,还要在之后快速的被淘汰出去,仅仅是因为自己按照正常的节奏一步步升级。完全感觉自己就是在陪那1-2个人玩游戏,甚至浪费了时间。

总结

酒馆战旗犯了一个所有的暴雪游戏的错误就是:暴雪爸爸教你玩游戏。我不仅一次对酒馆对随从的削弱感到奇怪,而且前期的一些随从配合也在暴雪的意料之外,比如跳操。随着暴雪发现,便开始在玩家的基础上对其进行改良,比如:5星镀金海盗,或者对其削弱,比如:圣盾峰哥鱼。暴雪将自己摆在了高于玩家一头的地位,由他来决定游戏的形式而不是玩家:我不喜欢太快结束战斗,我不喜欢圣盾剧毒的配合,我不喜欢过分强势的组合,我想让你们在那玩养成游戏,我想让你们慢点结束战斗等等。但是他的聪明才智又不足以支持他的野心,很多时候玩家往往能拿出不属于他们的创意,不属于他们的解决方案,然后他只能气急败坏的说:这是你能玩的么?你也姓赵。于是成就了一个玩家喜欢什么就砍什么的奇怪现象。炉石传说如此,魔兽世界如此,酒馆战旗也是如此。他们盛气凌人的模样让人生厌。他对自己游戏不信任不相信他们的酒馆战旗会像麻将,扑克这些,虽然形式单一,但是悠久流传。或者是他们不想要这样,因为他们对用户数有要求,他们希望无限的增长用户,他们希望获得用户的氪金。这或许是所有游戏公司的悲哀吧。所以他们在游戏刚更新之后立刻举行比赛,希望减少玩家思考时间防止玩家扯出什么幺蛾子,但是又不想一直保持游戏不变化。而玩家对此的投票也很正常,不玩,不带。不止一次比赛选手选择旧版本的卡组,一张新的版本卡都没带,这肯定不是暴雪想要看到的,但是对于选手来说,他们需要的是一个可以理解的,经过验证的卡组,而不是看起来花里胡哨的,他们对稳定的需求大于随机性的上限。

目前暴雪感觉进入了一个死亡螺旋:开新版本,举办比赛增加热度——比赛卡组都是旧的,并没有带来新版本热度——玩家觉得无聊,退坑——开新版本,增加更加强力的卡,举办比赛增加热度——比赛开组都是旧的。他一遍遍的增加可怕的,超模的新卡,新随从反而让更多人离开,更频繁的更新导致入门门槛不断增加,虽然氪金数上来了,但是用户数不断减少,最后的结果必然是成为了小众游戏,即使他当初是一个众所周知的游戏。

20220630141112

贴一下服务器配置:

  • cpu:1核

  • 内存:512M

  • 硬盘:10G

  • 带宽:1G

  • 流量:1000G/月

这个是搬瓦工的512M的洛杉矶CN2线路,访问国内速度很快,电信联通尤其好,移动差劲。

最近需要更换宽带,正好借此机会,研究一下:我的服务器对为啥对移动这么排斥,联通和电信哪个更好?根据后台的Billing,我可以看出我得服务器,在洛杉矶,机房代号为:USCA_2。

20220608110005

我查了下这个机房:

搬瓦工的洛杉矶DC2机房来自QN机房(全称QuadraNet机房),目前已接入CN2 GT直连线路,机房CN2直连线路由QN机房官方部署。

这个机房是有自己得服务器业务的,包括托管别人的服务器,搬瓦工就相当于把这个服务器放在人家那托管,至于速度啥的由这个机房自己控制。这个机房是有自己的官网的,有兴趣可以做些测试。网站也提供一些测试IP。

说完机房我们来说线路,我们经常听到CN2 GIA,CN2 GT线路之类的,简单说这两条线路都是中国电信的明星产品,GIA线路负载小,贵,所以快。GT性价比高,所以人多堵塞。但是这一切都是电信的线路。

搬瓦工后面自己发行了一个CN2 GIA线路的自主机房,这时候那些卖机子的就开始狂吹。其实完全没有必要,只要是任何中国直连的线路都有不错的速度。我们只需要关注对应机房是否对中国线路有没有进行优化就可以。

由于我的服务器在QuadraNet机房,归属于QuadraNet这个公司的,所以我不再使用自己的服务器IP进行测试,直接用他们洛杉矶机房提供的测试IP和文件进行测试:

20220608112920

这边官方贴心的提供了亚洲优化的IP,只用TraceRoute查询查询对应IP在对应线路下的跳转,使用TCP进行查询,最大化模拟访问。

| 访问IP | 节点数 |运营商|跨洋线路|落地表现|

| -| – |-----|—|-|

| 69.12.66.26-未优化 | 15 |电信|AS4134-163网络|到美国加利福尼亚,美国国内跳转5次,从cogentco跳转到QuadraNet

|69.12.66.26-未优化|18|移动|AS9808跳AS58453|到美国,国内跳转8次,从cogentco跳转到QuadraNet

|69.12.66.26-未优化|12|联通|AS4837-联通169网络|到美国,国内跳转3次,从cust.net跳转到QuadraNet

| 204.152.218.25-优化IP | 12 |电信|AS4134-163网络|到美国直达QuadraNet

|204.152.218.25-优化IP|16 |移动|AS9808跳AS58453|到美国后直达QuadraNet数据中心

|204.152.218.25-优化IP |11|联通|AS4837-联通169网络|到美国后到美国联通公司再直达QuadraNet

一通测试下来之后发现,这个机房的优化IP有效果,都可以在到达美国之后,直接跳转到机房,这个很重要。至于国内内部跳问题这个无解,就像移动老是喜欢跳香港(原因后面解释),再出国,联通喜欢走广东出国之类的。其实国内的内部跳转很快的都是1ms这些的,所以瓶颈在于跨洋线路和到美国之后的跳转,这些都是150+ms,跨洋线路的话,我这次测试没有遇见到的CN2 GT路线(AS4809),三大运营商用的都是自己的主要干线,如果高峰期这条线路堵塞卡顿也是正常的,特别吐槽下移动:AS9808为移动境内的骨干网,未设与国际ISP Peer,故所有出境流量通过AS58453(CMI)与外网互联,所以好好的就是速度比联通慢。

接下来测试自己VPS主机IP:

|运营商|节点数|跨洋线路|表现|

|-|-|-|-|

|电信|13|AS4134-163网络|到美国后直达

|联通|13|AS4837-联通169网络|到美国后直达

|移动|16|AS9808跳AS58453|到美国后直达

综合测试下来,我的服务器IP也享受到了QuadraNet的机房优化效果,至于电信的CN2线路,可以确定的是QuadraNet机房有接入这条线路,但是实际能不能用到要由机房决定。对几条骨干线路感兴趣的话,可以参考国内几大骨干网介绍和国内主流网络运营商国际连接线路简谈。

所以购买服务器的时候,只要是对国内线路有优化的服务器就可以,没必要追求CN2线路,那是电信的线路,除非是专线:即所有的进出都走且只能走这条线路,否则一般你你运营商都会选择走自己的骨干网络。而如果你是专线的话,又会涉及到跨运营商访问的问题,除非你手机,宽带都是电信,还有别人访问你的网络也都是电信。但是这往往是不可能的。而跨运营商访问话,需要看你的城市是否有国家级互联网骨干直联点。否则你的路由也得经由这个城市再转发到电信线路去。所以,说实话,直接普通的CN2线路就能满足大部分人的大多数需求。

其实本来是只剩下在细雨中呼唤还没写对应的读后感,现在接着这个机会,我也来说说前面几本书吧。我很久没看过小说了,很多时候我看的都是科普文章,冷静,真实且富有背后逻辑。所以,我在看这本小说的时候,我总是不由自主的想象它是真实的,它是真实发生在我们的过去和身边的。一想到这,我就不由得揪心。与其说是心疼书中得人物,还不如说是害怕自己成为书中得人物。

虽然四本书内容不行,形式不一,文笔也有差别,但是内核都是家庭,都是自己得人生。也许表象不一样,但是内核,或者从中看到得危机感总有一种身临其境得感觉。随着疫情两年,再加上国际形势得变化。谁能说自己不会沦落到富贵得境地,然而富贵还有几亩自留地,我们还有什么。失业不再是一个遥不可及得事情,尤其是现如今我已经因为疫情隔离在家一个月。其实我们和老板得关系并没有共产主义宣讲得那么敌对。我们需要工资养活自己,而老板发工资。所以,作为走狗得我们有时候会担心老板发不出工资,这比老板让我们996还要可怕。毕竟《活着》才是最重要得。我佩服富贵得韧性。

20220605111302

犹记得小时候听说过《活着》这本书,也看到过冯小刚演得《福贵》,当我看到富贵在酒馆和龙二赌博得场景,我内心满不住得愤怒,也为家珍和她肚子里的孩子感到不值,真的不值,我讨厌赌博,恨他们。同样得我也恨这本书,所以我一直没看。

在我一气呵成得读完之后,我对富贵得恨没了,取而代之得是悲,是哀,是无奈。余华将富贵得人生归纳在生死得失之间,将他的日常隐去,让我们从这个普通得小老百姓得生死得失之间领略人生得残酷。天地不仁,以万物为刍狗。富贵得事离我们很远,不远。我们也在这生死得失之间。如果哪天有人能为我写这么一篇简史,我也就满足了。

《兄弟》得话,一开始的时候我怀疑是不是写错了作者。我很少见到作者得写作风格差异如此之大,兄弟写得更长,也更细。细到我有点觉得无聊了。人和人之间大多数得事情都是大同小异得,而兄弟也和我妈他们喜爱得电视剧大同小异,都是讲述几个人得爱情,人生,长大成人,结婚生死,奋斗拼搏。不能说不好看,只是我不喜欢看电视剧,太拖拉。

《许三观卖血记》则又是一种写作风格得转换,这次使用得是对话,大把大把得长对话。内核依旧是家庭。有人说这是在写卖血。但是我不觉得,卖血只是一个噱头,你说他卖精,卖屁眼,甚至卖劳力也行。血对于许三观来说是自己家庭最后得保障。作为一家之主,作为一个需要养活一家老小得男人,卖血给了他底气。孩子惹事他能兜着,家里没米他能搞定,孩子工作上得道路他能帮忙,家里人生了重病他也能想到办法筹钱。卖血是他牺牲自己保护自己家人得工具,为何在许一乐去上海之后,他就再没卖过血了,因为那一次他知道了卖血的上限,他知道了不是什么事情都能牺牲自己就能解决的,如果最后许三观死在卖血的路上,许一乐也死在上海,最后的一段结尾是许三观自己的美好梦想,那么这个故事也能说通,也能完美的结束。现实生活并不是什么童话故事,它残忍,不仁,没有因果,也没有循环,有的只是在其中的你我。许三观死了,许一乐也死了,母亲一个人回去,终日郁郁,二乐回不来市里,在村里扎了根,三乐照顾着生病的母亲,艰难度日,再写下去,就又是一本《活着》。

《在细雨中呐喊》则又不一样。这次更多的聚焦在“我”的感情和想法上,如同一般的小说一样。大量的心理描写,引得读者渐入佳境。小说讲的还是家庭的事。家庭并不是一个坚不可摧的整体,它易散,不稳。在其中的大多数人都没有选择权,连一家之主也没有。它有可能像富贵一样,也有可能像呐喊中的我一样:虽然身在其中,但是一直想要逃离它。家庭并不总是你的避风港,有时候会是你的负担,让你在这人生路上更加的艰难险阻。孙光平早早的看到了这点,然后接受了它。或许现在的人无法想象父亲在一个家庭的重要性,但是我知道。在我们那里的家庭,母亲往往是不出声的,更多的是父亲在主持整个家庭,但是你说是因为父亲干的多么?不是,农活都是母亲在干或者母亲干的比较多。所以在我懵懂的时候,我是不明白,为啥女人要大太阳的下地干活,还要晚上回来炒菜备酒给一天闲活的丈夫呢?大概是他们都有着许三观一样的“卖血”门路吧,所以母亲们才对他隐忍有加。所以在一个男权家庭长大的我来说,我更加能体会到遇上一个像孙广才一样的父亲时,那是整个家庭悲哀,这个家庭注定是要灭亡的。孙有元的待遇在我看来并不是一个天方夜谭,很多时候爷爷辈存亡仅仅是因为一个没有根据的传言:老人活太久是在吸儿孙的寿命。所以孙有元的死更多是孙广才对自己家庭掌控力的一种表现。

我生在农村,活在农村。在农村见到过很多事,看见过很多人。有时候我完全不能理解他们。孙广才对孙有元的恨是没有来由的。他是他的父亲,他养育了他,虽然现在农活辛苦,但不至于多养一张嘴也养不起。而最近听闻的一件事,也让我陷入一样的迷惑:我二姑姑嫁在我们村西头去了,二姑父的弟弟是村里卫生所的医生,去年奶奶生病。需要打点滴,输营养液。那时候我大伯他们请的是别的村的医生,营养液也是从外面的药店买的。今天听说我姑姑对我们没去村里卫生所买有怨言。很多时候,人的想法是没有来由的,他们的恨也往往是由着这没有来由的想法带来的,孙广才觉得自己天天辛苦,下地种田,养活的却是这个越来越没用的孙有元。这个想法与其说是目光短浅,还不如说是任性的。就像我二姑的想法一样,就好像那无明的业火,忽然的就烧着了。没有深究,没有思考,就这么的骂了出来,吼了出来,扎根在自己的脑海中,并奉之为真理,然后就陷入了自我证明的道路,眼里看到的都是证明自己正确的镜像,越发的忽略了其他客观的事实。

孙广才的种种事情并没有让我惊讶,我就像里面的“我”一样,看清这一切,明白这一切,然后倾尽全力的离开这一切。

余华的四本书看起来风格迥异,但是内核都是一样的,或许我觉得他让我领略了四种不一样的父亲,余华的书中,对父亲这一角色的刻画比其他角色要多,他们都是推动剧情的主要工具,甚至在一些方面,他们就像是完美的存在,保护着自己的孩子,承担着一切。余华对父亲的刻画有浪子回头,有高达威猛,有世俗,也有杂种。父亲承担起了故事的走向,看来他很了解在这个父权的社会,一个家庭的好坏,父亲能决定大多数。

0%